El mensaje central. Tener la situación «bajo control» significa estar preparado para los errores y los fallos, en lugar de dar por hecho que nunca ocurrirán. Comience con un inventario y una evaluación exhaustivos de los riesgos, asigne responsabilidades claras e implante medidas de protección probadas antes de que se produzca un incidente. La seguridad de los sistemas primarios sigue siendo esencial; la monitorización redundante e independiente constituye la última línea de defensa para detectar cambios físicos perjudiciales y proporcionar tiempo para actuar, incluso durante los fallos de alimentación eléctrica o conectividad que esté diseñada para soportar. Mantenga toda la cadena gestionable y adaptable a los cambios en las condiciones mundiales y las amenazas: el objetivo es evitar daños irreversibles, no simplemente reaccionar más deprisa.
Resumen ejecutivo
Los ataques recientes contra instalaciones de refrigeración gestionadas a distancia en Europa muestran cómo los incidentes cibernéticos pueden provocar alteraciones físicas y pérdidas económicas. La prioridad es evitar los daños mediante la evaluación de riesgos, medidas de protección adecuadas y una respuesta probada, no confiar en una indemnización posterior. Los seguros no constituyen una red de seguridad completa: las limitaciones de la cobertura de los seguros de ciberseguridad pueden dejar pérdidas sin asegurar, según las condiciones de la póliza y las circunstancias del incidente. Las medidas de protección no garantizan que se eviten las pérdidas, y las indemnizaciones pueden no reparar por completo el daño reputacional.
La lección trasciende a un fabricante, una vulnerabilidad o un sector concretos, pero las consecuencias no son equivalentes. Los incidentes en el comercio minorista y la logística del frío pueden destruir existencias reemplazables e interrumpir la actividad, con las limitaciones de los seguros descritas anteriormente. En la fecundación in vitro (FIV), perder embriones de pacientes puede eliminar de forma permanente una oportunidad de tratamiento; en los biobancos, perder muestras longitudinales acumuladas durante décadas puede destruir material de investigación imposible de recrear. En los bancos de sangre, la alteración de productos celulares listos para transfusión puede poner en peligro su disponibilidad y la atención oportuna a los pacientes. Estas diferencias importan allí donde los equipos conectados controlan la temperatura, la humedad, la presión, la ventilación o las concentraciones de gases, incluidos laboratorios, hospitales, almacenes farmacéuticos, salas blancas y entornos de producción. Los responsables deben evaluar las consecuencias científicas, clínicas y operativas, junto con la pérdida de confianza de clientes, pacientes y socios, y no solo el coste de reposición.
Los responsables de TI pueden utilizar este documento para dialogar con la alta dirección, el director de instalaciones o el comité de auditoría de riesgos sobre la exposición, la atribución de responsabilidades y las pruebas de que las medidas de protección funcionan. La responsabilidad es compartida, pero externalizar la instalación o el mantenimiento no transfiere el riesgo operativo del propietario de los activos. Los fabricantes deben ofrecer productos seguros y con soporte; los integradores deben evitar arquitecturas inseguras; y los proveedores de mantenimiento deben controlar el acceso remoto privilegiado. Los clientes deben saber qué está conectado, asignar responsabilidades claras de seguridad y abordar la situación de los equipos sin soporte. Estas conversaciones deben desembocar en prioridades acordadas, acciones asignadas y decisiones claras sobre los asuntos que requieren aprobación de la dirección. Las medidas de protección desatendidas deben figurar en la agenda directiva como posibles fuentes de pérdidas no aseguradas y daños reputacionales, no solo como cuestiones de TI.
Incluso un sistema primario bien protegido puede fallar, configurarse incorrectamente o verse comprometido. El inventario y la evaluación de riesgos deben identificar los procesos críticos, evaluar los posibles fallos y sus consecuencias y definir medidas de protección proporcionadas. Para estos procesos, la monitorización redundante e independiente debe medir las condiciones físicas por separado, aplicar una lógica de alarma independiente y permitir una notificación, un escalado y un seguimiento fiables. La monitorización complementa la ciberseguridad preventiva; no sustituye una respuesta operativa probada cuya responsabilidad corresponda al centro. El objetivo es proporcionar tiempo para actuar antes de que las desviaciones perjudiciales provoquen pérdidas clínicas, científicas, operativas, económicas o reputacionales irreversibles.
Proteja las muestras antes de que la pérdida sea irreversible. Todo laboratorio que conserve muestras valiosas, no solo los laboratorios farmacéuticos, necesita una estrategia de protección basada en el riesgo. Identifique los posibles fallos y las consecuencias de perder las muestras y combine después prevención, monitorización independiente redundante y una respuesta operativa probada. El propósito no es simplemente activar una alarma, sino dar tiempo a las personas para actuar antes de que las muestras sufran daños irreversibles.
Un incidente cibernético con consecuencias físicas
La tecnología operativa se diferencia de las TI convencionales de oficina porque controla condiciones físicas. Un sistema de control comprometido puede modificar una temperatura, detener la ventilación, suprimir una alarma o activar una función de calentamiento. Por tanto, las consecuencias van más allá de la pérdida de datos o productividad: pueden amenazar productos, muestras irreemplazables, la atención al paciente, la investigación y la continuidad del negocio.
La gestión remota facilita el soporte de estos sistemas. Los técnicos pueden diagnosticar averías, ajustar parámetros y mantener instalaciones en múltiples ubicaciones sin desplazarse. Pero esa comodidad también abre una vía de acceso a funciones de control de gran alcance. Si una persona no autorizada accede a un controlador de supervisión, las herramientas habituales de configuración pueden bastar para alterar el proceso. Así, el mismo acceso que permite un mantenimiento eficiente puede convertirse en una fuente de riesgo físico.
Los incidentes europeos de refrigeración ilustran este riesgo: las informaciones públicas describen controladores remotos comprometidos y cambios en los parámetros de funcionamiento. Las autoridades aconsejaron a las organizaciones eliminar la exposición directa a internet, revisar la configuración completa y los programas de desescarche, actualizar el firmware, cambiar las credenciales predeterminadas y restablecer el acceso remoto únicamente mediante una conexión protegida. El problema no se limita a la refrigeración comercial; también afecta a servicios responsables de material biológico vital.
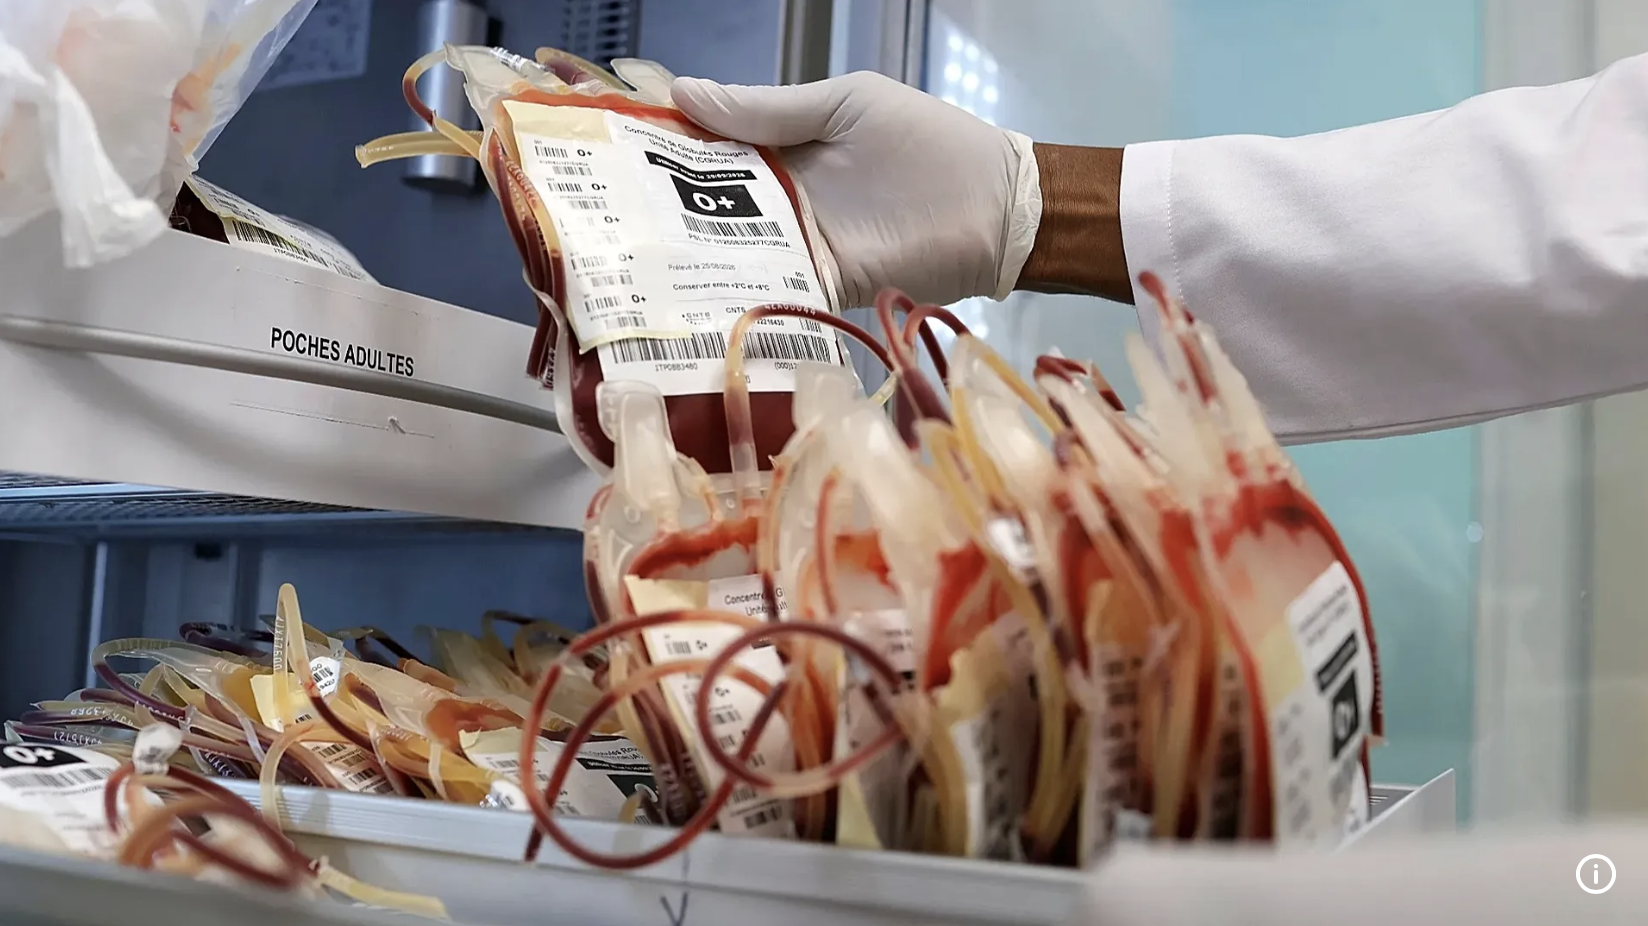
Las consecuencias también alcanzan a los servicios de sangre. En Francia, un incidente de ciberseguridad que afectó a un proveedor de refrigeración modificó los ajustes de temperatura y desescarche de las cámaras frigoríficas de los servicios de sangre. La monitorización y las alarmas permitieron intervenir rápidamente: los productos y las muestras se pusieron a salvo o se trasladaron, sin que se notificaran pérdidas de productos sanguíneos ni repercusiones sanitarias. En el Reino Unido, la alteración se produjo en otro punto de la cadena de los servicios de sangre: un ciberataque a servicios de anatomía patológica y análisis clínicos interrumpió las pruebas para transfusión sanguínea y las pruebas de compatibilidad cruzada, lo que aumentó la dependencia de la sangre del grupo O y contribuyó a una escasez nacional.
Estos incidentes muestran distintas vías de fallo, no un único método de ataque ni un autor común, pero evidencian por qué proteger los servicios de sangre exige atender tanto a las condiciones físicas de almacenamiento como a los servicios digitales que sustentan un suministro seguro. La lección común es que las debilidades de los equipos conectados, del acceso de los proveedores o de las TI de apoyo pueden interrumpir las operaciones. Por tanto, la resiliencia operativa debe abarcar toda la cadena, en lugar de un solo dispositivo o proveedor.
Un enfoque basado en el riesgo también debe ir más allá de atribuir un único motivo supuesto. Los escenarios pertinentes van desde delincuentes que buscan dinero mediante extorsión hasta el sabotaje deliberado, incluidos posibles motivos terroristas. La guerra híbrida es otro escenario que conviene considerar: el Consejo de la Unión Europea identifica los ciberataques y el sabotaje como elementos de las amenazas híbridas. Estas posibilidades no son explicaciones confirmadas de los incidentes aquí descritos; la atribución exige pruebas. Sea cual sea el motivo, el requisito operativo sigue siendo el mismo: proteger el acceso, detectar cambios perjudiciales y mantener una respuesta eficaz durante todo el ciclo de vida del sistema.
La seguridad desde el diseño debe mantenerse durante el funcionamiento
La seguridad desde el diseño suele plantearse como un principio de desarrollo de productos. En los sistemas de control debe ir mucho más allá. Un producto seguro puede dejar de serlo si se instala detrás de un puerto abierto, se configura con credenciales compartidas, se mantiene con firmware obsoleto o se atiende mediante una vía de acceso remoto no controlada. A la inversa, una buena segmentación de red no puede compensar indefinidamente un controlador que ya no recibe actualizaciones de seguridad.
La serie IEC 62443 ofrece un marco para proteger los sistemas de automatización y control industriales. Vincula la seguridad del producto, la arquitectura del sistema y las responsabilidades operativas mediante un enfoque de responsabilidad compartida. Fabricantes, integradores, proveedores de servicios y propietarios de activos deben gestionar los riesgos bajo su control y coordinar la protección durante toda la vida operativa de la instalación. Por ello, el marco no es simplemente un conjunto de medidas de red que se aplican tras la instalación: sus principios deben orientar el diseño del producto y seguir formando parte de la integración, el funcionamiento y el soporte continuo.
En los sistemas de control expuestos a internet o accesibles a distancia, la seguridad debe comenzar en la fase de diseño del producto, no añadirse después de la instalación. Desatender los principios pertinentes de IEC 62443 puede introducir debilidades en la autenticación, la separación de privilegios, el tratamiento de entradas y los mecanismos de actualización que la segmentación de red o una operación cuidadosa, por sí solas, no pueden resolver de forma fiable. El diseño debe establecer una autenticación robusta sin secretos predeterminados, compartidos o predecibles, separar la autoridad de configuración de la monitorización de solo lectura, permitir atribuir los cambios importantes a un usuario concreto y proporcionar actualizaciones seguras del firmware con períodos de soporte transparentes. Estas protecciones deben mantenerse durante la integración, la puesta en servicio y el funcionamiento continuo. No obstante, aplicar los principios de IEC 62443 no garantiza un producto libre de fallos. La gestión remota debe utilizar vías de acceso protegidas en lugar de la exposición directa a la internet pública, y los riesgos residuales deben documentarse y evaluarse.
Zonas y conductos: controlar los límites de confianza
IEC 62443 agrupa los activos con requisitos de seguridad comunes en zonas, conectadas mediante conductos controlados. Una arquitectura ilustrativa separa una zona de sensores para la medición y la adquisición, una zona de sistemas de control para controladores y actuadores, y una zona de sistemas de supervisión operativa para aplicaciones de supervisión e interfaces de operador. Las TI de oficina y el acceso de mantenimiento externo pueden ocupar zonas separadas. Los conductos definen los orígenes, destinos, protocolos y sentidos de comunicación permitidos, que se imponen mediante pasarelas, cortafuegos u otros controles de frontera. Las conexiones de medición, supervisión y mantenimiento no deben proporcionar acceso de control sin restricciones. Los diagramas y las etiquetas VLAN, por sí solos, no protegen: los límites deben restringir el tráfico. La segmentación limita la exposición y la propagación de una intrusión, pero no repara los controladores vulnerables ni establece la independencia de la monitorización. Véase Aspectos de seguridad de las zonas y los conductos en IEC 62443.
La elusión de la autenticación y el tratamiento inseguro de entradas son fallos de seguridad del producto
Los incidentes de refrigeración demuestran las consecuencias físicas del control no autorizado. Por separado, una investigación de vulnerabilidades ha documentado la elusión de la autenticación y la inyección de comandos: defectos de seguridad del producto en las versiones afectadas, no meros errores de implantación. Eludir la autenticación anula los controles de identidad; permitir que entradas no fiables se conviertan en comandos ejecutables revela un tratamiento inseguro de las entradas. Los fabricantes deben corregir estos fallos; la segmentación no puede sustituir a los productos seguros. La protección exige autenticación y autorización en todas las vías de acceso privilegiado, validación de entradas en el servidor y separación entre los datos y las instrucciones ejecutables. La investigación acredita defectos de diseño o implementación, no la vía de explotación de cada ataque. Siguen siendo necesarios el firmware actualizado, el acceso controlado y las medidas de protección verificadas.
La investigación de Midnight Blue de noviembre de 2026 refuerza esta distinción: los investigadores notificaron múltiples vulnerabilidades que permitían la ejecución remota de código sin autenticación en controladores de refrigeración, incluido el firmware más reciente que evaluaron en aquel momento. Por tanto, actualizar el firmware o cambiar las contraseñas no basta para demostrar que un sistema expuesto es seguro. Debe eliminarse la exposición directa a internet sin esperar a los parches, sin dejar de incorporar las actualizaciones de seguridad disponibles al mantenimiento controlado del ciclo de vida. Estos hallazgos refuerzan la necesidad de un diseño seguro del producto y de un acceso remoto restringido.
Del marco al ciclo de vida: mantener la protección en cada etapa
Estos principios hacen necesario un modelo de ciclo de vida: el diseño seguro establece los cimientos, pero la protección puede debilitarse por las decisiones de instalación, los cambios de configuración, el acceso remoto o el fin del soporte de seguridad. Por tanto, un modelo de seguridad creíble debe abarcar el diseño del producto, la integración, la verificación y validación, la puesta en servicio, el soporte remoto, la aplicación de parches y actualizaciones, la respuesta a incidentes y la sustitución final. Estas actividades son responsabilidades conectadas, no una lista de comprobación que se completa una sola vez al entregar la instalación. Durante todo el ciclo de vida deben mantenerse los principios básicos de seguridad de TI, una atribución clara de responsabilidades y medidas de protección coordinadas para que la instalación siga siendo segura, cuente con soporte y resulte gestionable a medida que cambian las condiciones.
Figura 1: Modelo de seguridad del ciclo de vida de un sistema de control.
Dónde fallan las organizaciones y cuánto cuesta
El fabricante: funcionalidad sin un ciclo de vida seguro
El fabricante crea la primera línea de defensa. La debilidad comienza cuando se prioriza la facilidad de mantenimiento remoto frente a una arquitectura segura, o cuando un dispositivo contiene mecanismos de acceso no documentados, controles de identidad débiles o registros insuficientes. También surge cuando las actualizaciones son difíciles de desplegar o cuando el soporte termina sin una vía de migración realista.
Las consecuencias pueden extenderse mucho más allá de un solo dispositivo. Un controlador de supervisión puede gestionar muchos activos conectados, y un producto común suele desplegarse del mismo modo en numerosos centros. Así, una debilidad puede repetirse. Los fabricantes deben valorarse no solo por si el equipo funciona hoy, sino por si puede seguir siendo seguro, actualizable y contar con soporte durante toda su vida operativa prevista.
Los fabricantes tienen una responsabilidad especial porque los clientes pueden no reconocer cuándo la comodidad, el ahorro de costes o unos valores predeterminados débiles encubren atajos en materia de seguridad. La falta de conocimientos técnicos del cliente no debe convertirse en una excusa para un diseño inseguro o compromisos de soporte poco claros. El Reglamento de Ciberresiliencia de la UE (CRA), Reglamento (UE) 2024/2847, atribuye a los fabricantes de productos comprendidos en su ámbito de aplicación la responsabilidad de evaluar los riesgos, incorporar seguridad desde el diseño y por defecto, proporcionar instrucciones claras para los usuarios, declarar un período de soporte y gestionar las vulnerabilidades durante ese período. Esto refuerza el principio de que los clientes no deberían tener que descubrir debilidades ocultas para que los fabricantes las aborden. Las obligaciones principales del CRA se aplican a partir del 11 de diciembre de 2027, mientras que las obligaciones de notificación se aplican desde el 11 de septiembre de 2026. Debe comprobarse la aplicabilidad a cada producto, incluidas las exclusiones pertinentes; el CRA no elimina la responsabilidad del cliente de operar de forma segura.
El propietario de los activos: conservar equipos porque aún funcionan
Un equipo que funciona no es necesariamente seguro. Un controlador puede regular correctamente la temperatura mientras su modelo de seguridad está obsoleto. En los equipos conectados en red que afectan a procesos críticos, el fin del soporte de seguridad debe dar lugar a su sustitución, su aislamiento o una excepción de corta duración aprobada formalmente con controles compensatorios.
«Esto me ha funcionado durante los últimos veinte años. ¿Por qué deberíamos cambiar una solución que funciona?» Esta objeción ilustrativa confunde la fiabilidad pasada con la protección actual. Los equipos pueden permanecer sin cambios mientras las amenazas evolucionan rápidamente. Su conservación debe depender de que la conectividad, el soporte y las medidas de protección sigan siendo adecuados para su finalidad, con el respaldo de una decisión de riesgo documentada, no solo de su longevidad.
Las consecuencias de una demora no pueden medirse únicamente por una baja de existencias. Las existencias del comercio minorista pueden ser reemplazables, aunque persistan la interrupción de la actividad y las carencias de cobertura del seguro. Los embriones de pacientes y las muestras longitudinales únicas de los biobancos pueden no ser reemplazables en absoluto. La pérdida de componentes sanguíneos utilizables puede impedir una atención transfusional oportuna. Por ello, los propietarios de activos deben evaluar la pérdida irreversible, la interrupción del tratamiento y las consecuencias científicas, no solo el valor contable del activo o una posible indemnización del seguro.
El integrador: convertir el servicio remoto en exposición pública
Fabricantes e integradores pueden ser una misma organización o empresas distintas. En ambos casos se aplican las dos responsabilidades: explicar las capacidades y limitaciones de seguridad del producto y entregar una instalación segura. Los proveedores separados añaden interfaces y traspasos; ninguna parte puede suponer que la otra se responsabiliza de un riesgo sin resolver.
La exposición pública, el reenvío amplio de puertos, las contraseñas reutilizadas y las reglas de cortafuegos no documentadas pueden debilitar un producto capaz. La entrega debe documentar la arquitectura, los flujos de datos, los permisos, la configuración de seguridad, los registros, la responsabilidad sobre los parches y el aislamiento seguro, dejando claras para el cliente las facultades de acceso y modificación.
Desde el diseño hasta la operación, el integrador y el proveedor interno o externo de TI del cliente deben acordar la segmentación, el acceso remoto protegido, las cuentas individuales, las aprobaciones, los registros, la monitorización y la integración con la respuesta a incidentes. Los controles deben proteger la ciberseguridad sin alterar las operaciones críticas.
Tras la entrega, el cliente, el integrador y el proveedor de TI deben mantener la documentación y la atribución de responsabilidades sobre los cambios, las actualizaciones, las revisiones de acceso, la recuperación y la sustitución, con la participación del fabricante cuando sea necesario. Los cambios en los equipos o en el entorno de TI deben activar una revisión coordinada para preservar la seguridad y la capacidad de soporte durante el ciclo de vida.
El proveedor de mantenimiento: acceso remoto sin una rendición de cuentas equivalente
El mantenimiento remoto concede acceso privilegiado a los procesos físicos. Los técnicos pueden conocer los equipos sin ser especialistas en ciberseguridad, por lo que los proveedores deben facilitar un trabajo seguro mediante herramientas accesibles, formación y procedimientos. Los controles deben proteger las instalaciones sin obstaculizar el mantenimiento rutinario ni las intervenciones urgentes.
Utilice cuentas nominativas, autenticación robusta, permisos definidos y sesiones registradas. Planifique un acceso de emergencia controlado en lugar de eludir las medidas de protección. Junto con el proveedor de TI del cliente, asegúrese de que el acceso pueda concederse, revisarse y revocarse eficientemente, también para los subcontratistas. La seguridad debe reducir el riesgo global sin crear problemas operativos mayores.
Para las organizaciones comprendidas en el ámbito de NIS2, el acceso de mantenimiento de terceros también es una cuestión de cumplimiento en la cadena de suministro. El artículo 21 exige que la gestión de riesgos de ciberseguridad aborde a los proveedores directos y prestadores de servicios, los controles de acceso y la eficacia de las medidas de protección. Por tanto, un acceso remoto no controlado o no monitorizado puede representar una carencia grave de cumplimiento, sujeta a la legislación nacional aplicable y al perfil de riesgo de la organización. Los contratos de mantenimiento deben definir la aprobación del acceso, la autenticación, los registros, la monitorización, la revocación y las responsabilidades ante incidentes, con pruebas de que estos controles funcionan en la práctica.
TI internas, instalaciones y dirección: vacíos entre responsabilidades
Los equipos conectados de refrigeración, calefacción, ventilación y aire acondicionado (HVAC) y laboratorio abarcan TI, instalaciones, calidad y operaciones. El personal puede comprender su finalidad y, sin embargo, pasar por alto dependencias de red, riesgos del acceso remoto o requisitos de soporte. Cuando TI ve equipos de instalaciones, instalaciones confía en el proveedor y calidad se centra en el cumplimiento, las medidas esenciales de protección pueden carecer de un responsable de extremo a extremo.
La dirección debe asignar responsabilidades y reunir a los equipos internos y a los proveedores en torno a una gestión compartida del riesgo, dependencias claras y vías de escalado. Externalizar tareas no transfiere la responsabilidad por el riesgo operativo. Los equipos sin soporte, la atribución poco clara de responsabilidades y el acceso no verificado de los proveedores deben seguir siendo visibles; las decisiones de sustitución y monitorización independiente deben reflejar las consecuencias del fallo, no solo su probabilidad o el precio de compra.
Figura 2: Relaciones y responsabilidades compartidas entre todas las partes interesadas.
Gestionar una coordinación de proveedores cada vez más compleja
A medida que intervienen más partes interesadas, implantar y mantener una solución fiable plantea un reto mayor de coordinación. Cada parte adicional introduce interfaces, dependencias, pasos de aprobación y posibles vacíos de responsabilidad. Un cambio sencillo dentro de una organización puede exigir el acuerdo de varios proveedores, ralentizando la respuesta cuando las condiciones mundiales, las amenazas o los requisitos operativos cambian rápidamente. Por ello, una solución debe valorarse no solo por el funcionamiento de sus componentes individuales, sino por la posibilidad de gestionar, probar y adaptar toda la cadena en el tiempo disponible.
Por tanto, las organizaciones deberían considerar reducir los traspasos innecesarios entre proveedores y seleccionar proveedores de soluciones capaces de coordinar la cadena de resiliencia operativa de extremo a extremo, en lugar de gestionar componentes aislados. Dentro de un alcance contractual claramente definido, el proveedor debería responsabilizarse de implantar y mantener las medidas de protección acordadas en diseño, integración, monitorización, mantenimiento, escalado y recuperación. El cliente conserva la responsabilidad de aceptar los riesgos, tomar decisiones operativas y organizar la respuesta humana. El objetivo es reducir los vacíos entre estas actividades, con autoridad clara para coordinar los cambios con rapidez.
Esto no significa excluir a partes interesadas esenciales ni suponer que un único proveedor elimina todos los riesgos. La consolidación de proveedores y la independencia de la monitorización abordan cuestiones diferentes: menos traspasos pueden simplificar la coordinación, mientras que la medición y la evaluación de alarmas separadas y unos sistemas de alimentación y comunicación suficientemente independientes reducen los riesgos de fallos compartidos. Cualquier solución consolidada debe demostrar esa independencia, preservar responsabilidades transparentes y la supervisión del cliente, e incluir un plan creíble de continuidad y salida. El objetivo es un sistema más sencillo, con responsabilidades más claras, que siga siendo fiable en el funcionamiento diario y adaptable cuando cambien las circunstancias.
Por qué la prevención por sí sola no basta
Una buena ciberseguridad reduce la probabilidad de intrusión, pero no puede garantizar que nunca se produzca. Pueden robarse credenciales, un proveedor de confianza puede sufrir una intrusión, un error de configuración puede exponer un sistema y un técnico legítimo puede realizar un cambio perjudicial. Pueden existir nuevas vulnerabilidades antes de que haya un parche disponible. Incluso una actualización segura puede producir un efecto operativo imprevisto.
Por ello, un diseño resiliente considera dos preguntas al mismo tiempo. ¿Cómo impedimos el acceso no autorizado? ¿Y cómo detectamos la consecuencia física si, pese a todo, algo falla en el acceso, la configuración o el control? La primera pregunta corresponde a la seguridad preventiva. La segunda requiere una fuente independiente de información fiable.
Una distinción fundamental. Una alarma generada por el mismo controlador que está siendo manipulado no constituye una capa de protección plenamente independiente. La independencia real requiere medición separada, evaluación separada y, cuando proceda, una alimentación eléctrica y una vía de comunicación separadas.
La monitorización independiente como segunda fuente de información fiable
La vía de control y la vía de monitorización independiente, una junto a la otra.
La monitorización independiente proporciona una segunda fuente de información fiable al medir las condiciones físicas por separado del controlador primario y aplicar límites de alarma gestionados de forma independiente. El incidente de los servicios de sangre franceses descrito anteriormente demuestra el valor práctico de la monitorización, las alarmas y la intervención oportuna: los productos y las muestras se pusieron a salvo o se trasladaron, sin que se notificaran pérdidas de productos sanguíneos ni repercusiones sanitarias. Ese resultado respalda la utilidad de un aviso eficaz, pero no demuestra por sí mismo la independencia arquitectónica o la redundancia de los sistemas implicados.
La monitorización eficaz debe seguir disponible durante los fallos que pretende revelar. Un incidente de mayor alcance puede interrumpir la conexión a internet o la alimentación eléctrica de todo un centro, lo que podría desactivar tanto el equipo primario como su cadena de alarmas. Por tanto, la monitorización independiente necesita redundancia suficiente para mantener el aviso y el escalado en los escenarios de interrupción identificados en la evaluación de riesgos. No puede prevenir el ataque inicial ni mantener por sí sola en funcionamiento los equipos controlados.
La redundancia debe extenderse a toda la cadena de monitorización, no limitarse a un sensor o un panel de control adicional. La evaluación de riesgos debe definir los escenarios de interrupción y la duración del funcionamiento autónomo que el sistema esté diseñado para soportar, junto con los medios necesarios para mantener la medición, la evaluación local de alarmas, el almacenamiento temporal de datos, la alimentación de respaldo y las vías alternativas de comunicación. Una vía de respaldo no debe depender de la misma conexión o fuente de alimentación cuyo fallo pretende cubrir. Se aplican los mismos principios de diseño seguro y gestión del ciclo de vida: el sistema debe mantenerse, actualizarse y probarse, incluidos ejercicios que retiren la alimentación normal y el acceso a internet y verifiquen que las alarmas siguen llegando a personas capaces de actuar. Estas medidas proporcionan una oportunidad de intervenir a tiempo; no garantizan que puedan evitarse todas las pérdidas. Cualquier limitación restante debe comprenderse y aceptarse mediante el proceso de evaluación de riesgos.
Un modelo operativo más maduro
Un modelo operativo maduro comienza con un inventario y una evaluación exhaustivos de los riesgos, no con la compra de equipos ni con la suposición de que las medidas de protección existentes bastan. Las organizaciones deben identificar los procesos críticos, las muestras valiosas y los activos conectados; comprender sus dependencias de la alimentación eléctrica, las redes y los proveedores; y evaluar las consecuencias de un fallo o una intrusión. La evaluación debe establecer qué riesgos requieren medidas, quién es responsable de ellos y qué nivel de protección y continuidad se necesita. Proporciona la base para decidir sobre conectividad segura, sustitución de equipos, monitorización independiente y respuesta humana.
Cuando los clientes carezcan de los conocimientos, recursos o capacidad para realizar este trabajo por sí mismos, deberían contratar a una empresa especializada con una trayectoria demostrable y capacidad para evaluar su entorno operativo. La selección debe basarse en experiencia pertinente, un método de evaluación claro y pruebas de que el proveedor puede traducir los hallazgos en medidas de protección prácticas y gestionables, no limitarse a recomendar productos. El trabajo debe implicar a los equipos de operaciones, TI, instalaciones y calidad del cliente para comprender conjuntamente las dependencias técnicas y las consecuencias de perder muestras o servicios. El apoyo externo refuerza la evaluación; no transfiere la responsabilidad del cliente de aceptar y gestionar el riesgo.
El resultado debe ser un plan de acción documentado y priorizado, con responsabilidades claras, plazos acordados y financiación. Debe abordar la exposición remota, los controles de acceso, el estado del firmware y del soporte, las responsabilidades de los proveedores, el aislamiento seguro y la independencia y redundancia de la monitorización. A continuación, las medidas de protección deben verificarse mediante pruebas de la cadena de alarmas, ejercicios de respuesta fuera del horario habitual y comprobaciones ante la pérdida de la alimentación o la conectividad normales. El inventario y la evaluación de riesgos son responsabilidades continuas: deben revisarse cuando cambien los equipos, los proveedores, la conectividad o las amenazas, para que la protección siga ajustándose al entorno operativo real.
XiltriX Resilience contribuye a la resiliencia operativa
XiltriX Resilience está diseñado para contribuir a la resiliencia operativa mediante una capa de monitorización independiente en entornos de misión crítica. Su aportación combina infraestructura física, inteligencia de monitorización y atención continua, en lugar de depender de un único sensor o una función de software. Estos elementos facilitan la detección, la notificación y el seguimiento, pero una protección eficaz también depende de la seguridad del sistema primario del cliente, de sus decisiones sobre el riesgo y de la respuesta humana. La tecnología y el servicio deben trabajar juntos dentro de ese modelo de responsabilidad compartida.
Infrastructure: medir la realidad física
Las estaciones de monitorización y los sensores dedicados crean una vía de medición ajena a la lógica de control primaria. Según la aplicación, puede incluir temperatura, humedad, presión diferencial, oxígeno, dióxido de carbono, estado de puertas, contactos de alarma de los equipos, estado de la alimentación eléctrica y estado de las comunicaciones. El almacenamiento temporal local y el funcionamiento con respaldo de baterías ayudan a conservar las evidencias y la visibilidad durante las interrupciones.
De la medición física a la respuesta adecuada
-
Los sensores independientes miden incubadoras, frigoríficos, condiciones ambientales y almacenamiento criogénico.
-
Las estaciones de monitorización dedicadas proporcionan almacenamiento temporal local y funcionamiento con respaldo de baterías.
-
El alojamiento seguro en la nube da soporte a los datos de monitorización, SSO y la API REST.
-
Las desviaciones ambientales siguen la vía de notificación y escalado definida por el cliente hasta el equipo del centro.
-
Los fallos del sistema de monitorización se derivan al soporte técnico de XiltriX; el soporte técnico remoto 24/7 forma parte de Intelligence.
Figura 3: Las capacidades de XiltriX Resilience (www.xiltrix.com)
Intelligence: detectar y comunicar lo importante
La capa de software evalúa continuamente las mediciones, gestiona los umbrales de alarma y proporciona paneles de control, notificaciones, escalado, informes de incidentes y evidencias de cumplimiento. El diagnóstico remoto y la monitorización del estado del sistema ayudan a distinguir las desviaciones ambientales de los problemas de sensores, alimentación o comunicación. La plataforma de monitorización también requiere alojamiento seguro en la nube y una gestión continua del ciclo de vida del software para que siga contando con soporte, en lugar de convertirse en un sistema heredado sin gestionar.
Intelligence incluye actualizaciones de software y firmware OTA y soporte técnico remoto 24/7 para el propio sistema de monitorización. El cliente sigue siendo responsable de responder a las alarmas ambientales y de los equipos.
Care: servicios presenciales
Care abarca los servicios presenciales: instalación por socios con el apoyo de XiltriX, puesta en servicio, validación, formación, calibración y mantenimiento.
Responsabilidades de monitorización técnica y respuesta del cliente
XiltriX es responsable de la cadena técnica de monitorización, incluidas la medición, el registro de datos, la generación de alarmas y la entrega técnica de notificaciones dentro del alcance de servicio acordado. El soporte técnico de XiltriX se encarga de los fallos del sistema de monitorización. El equipo del centro o del cliente sigue siendo responsable de mantener los contactos de alarma y los procedimientos de respuesta, acusar recibo de las alarmas operativas, evaluar su importancia y actuar a tiempo para proteger las muestras, los productos y los pacientes. La entrega técnica de alarmas no constituye una intervención operativa.
¿Añade la monitorización de XiltriX una superficie de ataque?
La configuración de monitorización de XiltriX separa la medición del control: los sensores Pt1000, las señales de 4–20 mA y las entradas de contacto seco captan las condiciones físicas con independencia del lazo de control primario o de los PLC. En esta configuración no se proporciona ninguna conexión con actuadores ni de escritura en controladores: la monitorización no puede cambiar a distancia las consignas ni apagar las enfriadoras. La telemetría cifrada utiliza conexiones iniciadas desde el interior hacia el exterior, sin necesidad de puertos de entrada en el cortafuegos ni reenvío de puertos. Las opciones de despliegue incluyen una VLAN dedicada y segmentada mediante cortafuegos o una vía exclusivamente celular separada de la red del centro, no un aislamiento físico real de la red. El equipo de TI/seguridad del cliente debe verificar los flujos de datos desplegados, el aislamiento y la ausencia de vías de control antes de aprobarlos.
Nota importante. XiltriX Resilience no debe presentarse como un motivo para tolerar un controlador primario inseguro. Es una capa de defensa en profundidad que reduce la dependencia de un único controlador, red, vía de comunicación u organización de servicio. El entorno primario debe seguir protegiéndose, recibiendo parches y sustituyéndose cuando finalice el soporte.
Preguntas que los responsables deberían poder responder
Los responsables de cualquier empresa necesitan tener la situación «bajo control», no solo los de entornos farmacéuticos u otros muy regulados. Esto significa comprender los riesgos que asume la organización, las consecuencias de los fallos y las opciones de mitigación disponibles para reducir esos riesgos. No exige dominar todos los detalles técnicos ni eliminar todos los riesgos. Exige un inventario y una evaluación de riesgos actualizados, decisiones informadas sobre medidas de protección proporcionadas, responsabilidades claras y pruebas de que esas medidas funcionan. Los responsables deben comprender el riesgo que persiste tras la mitigación y decidir explícitamente si es aceptable.
La prueba «Conocer, contactar, actuar»: si el controlador primario se viera comprometido y fallaran la alimentación normal y el acceso a internet, ¿conoceríamos las condiciones físicas de forma independiente, contactaríamos con una persona responsable y actuaríamos antes de que se produjeran daños irreversibles? Para superar la prueba se requiere una medición independiente demostrada, una vía de notificación y escalado probada y una respuesta bajo la responsabilidad del centro completada dentro del tiempo disponible en el escenario evaluado. Una alarma por sí sola no basta para superar la prueba.
Las preguntas esenciales son prácticas: ¿qué sistemas conectados pueden afectar a un proceso crítico y quién puede acceder a ellos? ¿Se autentica y registra individualmente el acceso? ¿Cuándo termina el soporte de seguridad y pueden aislarse los equipos con seguridad? ¿Qué ocurre si dejan de estar disponibles la alimentación eléctrica, la conexión a internet o un proveedor clave? ¿Qué controles preventivos, monitorización independiente y medidas de recuperación pueden limitar las consecuencias y quién responde fuera del horario habitual? Cuando falten conocimientos especializados, los responsables deberían obtener apoyo cualificado sin renunciar a la supervisión. Tener la situación «bajo control» significa poder explicar estas decisiones y demostrar su ejecución y seguimiento, no simplemente suponer que TI o un proveedor se ha ocupado de todo.
La legislación europea de ciberseguridad confiere a esta responsabilidad una dimensión jurídica para las organizaciones comprendidas en su ámbito de aplicación. El artículo 20 de la Directiva NIS2 exige a los Estados miembros garantizar que los órganos de dirección de las entidades esenciales e importantes aprueben las medidas de gestión de riesgos de ciberseguridad, supervisen su aplicación y puedan ser considerados responsables de las infracciones de esos deberes. También exige que los miembros de los órganos de dirección reciban formación. Las obligaciones aplicables y los mecanismos de responsabilidad deben comprobarse en la legislación nacional de transposición; estas disposiciones no se aplican indiscriminadamente a todas las empresas.
El Reglamento de Ciberresiliencia (CRA), Reglamento (UE) 2024/2847, establece por separado responsabilidades de seguridad del producto para los fabricantes de productos comprendidos en su ámbito de aplicación, incluidas la evaluación de riesgos, la seguridad desde el diseño y por defecto y la gestión de vulnerabilidades durante el período de soporte declarado. Los responsables de los fabricantes afectados deben garantizar que sus organizaciones puedan cumplir estas responsabilidades; el CRA no debe presentarse como si impusiera el mismo régimen de responsabilidad personal de la dirección que NIS2. Las obligaciones de notificación del CRA se aplican desde el 11 de septiembre de 2026; sus obligaciones principales se aplican a partir del 11 de diciembre de 2027. Los responsables deberían determinar qué normas se aplican a su organización y sus productos y obtener asesoramiento jurídico cuando sea necesario. El principio general de gestión sigue siendo pertinente para cualquier empresa: comprender la exposición, elegir medidas de mitigación adecuadas y conservar pruebas de una supervisión informada.
Conclusión
Los incidentes europeos de refrigeración no son un motivo para esperar a la próxima advertencia. Revelan cómo el acceso remoto, los equipos heredados y la responsabilidad fragmentada pueden convertir una intrusión digital en una pérdida física. Se prevé que la presión aumente: el Centro Nacional de Ciberseguridad del Reino Unido considera casi seguro que la IA aumentará la frecuencia y la intensidad de las amenazas cibernéticas, y muy probable que el volumen y el impacto de las intrusiones crezcan hasta 2027. A medida que los ataques se vuelven más frecuentes y eficientes, las organizaciones corren el riesgo de verse superadas por el esfuerzo necesario para detectar, coordinar y responder. Confiar en que las personas reaccionen más deprisa después de cada incidente no es una estrategia de protección sostenible.
Los responsables de cualquier empresa deben tener la situación «bajo control» antes de que comience un incidente. Esto exige un inventario y una evaluación de riesgos actualizados, decisiones explícitas sobre mitigación y responsabilidades claras entre fabricantes, integradores, proveedores de mantenimiento y equipos internos. Los equipos sin soporte y los accesos poco claros de los proveedores deben abordarse, no tolerarse porque la instalación todavía funcione. Cuando falten conocimientos especializados, debe recurrirse a apoyo cualificado. El objetivo es reducir la exposición y eliminar las demoras evitables antes de que un cambio perjudicial exija una respuesta urgente.
Aun así, la prevención no puede ser la única barrera entre un ataque y un daño irreversible. La monitorización independiente es la última línea de defensa para detectar cambios físicos perjudiciales, y sus sistemas de alimentación, comunicación y escalado deben soportar los fallos que pretende revelar. Esos sistemas deben probarse junto con las personas autorizadas para actuar. Conforme aumenta la presión de los ataques, cada demora evitable consume tiempo que puede ser necesario para proteger muestras, productos y servicios. La resiliencia debe diseñarse, mantenerse y ensayarse de antemano: una vez que comienza el daño físico, puede no haber una segunda oportunidad.
Reflexión final. La resiliencia operativa parte de la premisa de que se producirán fallos. Requiere medidas de mitigación probadas, diseñadas para detectar los problemas pronto, limitar sus consecuencias y proporcionar tiempo para actuar antes de que se produzcan daños irreversibles. Esas medidas de protección deben seguir siendo adaptables a medida que cambian las condiciones mundiales, las amenazas y las exigencias operativas.
Referencias
-
Wikipedia, Tecnología operativa (definición de contexto). Consultado el 5 de noviembre de 2026.
-
CERT-FR, CERTFR-2026-ALE-012, Incidente de seguridad dirigido contra los controladores remotos de las instalaciones de refrigeración, 12 de octubre de 2026, actualizado el 16 de octubre de 2026. Consultado el 18 de noviembre de 2026.
-
Serie EN IEC 62443: Parte 4-1, Requisitos del ciclo de vida de desarrollo seguro de productos; Parte 2-4, Requisitos del programa de seguridad para proveedores de servicios IACS; y Parte 3-3, Requisitos de seguridad del sistema y niveles de seguridad. Descripción general de apoyo: NEN, IEC 62443: Ciberseguridad industrial. Consultado el 5 de noviembre de 2026.
-
Directiva (UE) 2022/2555 (NIS2), artículos 20–21: gobernanza y medidas de gestión de riesgos de ciberseguridad. Consultado el 5 de noviembre de 2026.
-
Comisión Europea, Reglamento de Ciberresiliencia: fabricantes y Reglamento de Ciberresiliencia: calendario de aplicación. Consultado el 5 de noviembre de 2026.
-
Centro Nacional de Ciberseguridad del Reino Unido, Impacto de la IA en la amenaza cibernética desde ahora hasta 2027, 2025. Consultado el 5 de noviembre de 2026.
-
Établissement français du sang (EFS), comunicado sobre el incidente de ciberseguridad que afectó a un proveedor de equipos de refrigeración, noviembre de 2026. Consultado el 5 de noviembre de 2026.
-
NHS England – Londres, Último comunicado de prensa sobre el ciberataque a Synnovis. Consultado el 5 de noviembre de 2026.
-
Consejo de la Unión Europea, Amenazas híbridas. Consultado el 5 de noviembre de 2026.
-
NIS2 Info, Directiva NIS2: artículo 20 – Gobernanza (reproducción secundaria de la disposición; la Directiva oficial figura más arriba). Consultado el 5 de noviembre de 2026.
-
NU.nl, información sobre ciberataques a sistemas de refrigeración y cobertura de seguros para existencias deterioradas (enlazado en el resumen ejecutivo).
-
XiltriX International, sitio web de la empresa (enlazado en la Figura 3).
-
Jaatun y otros, Aspectos de seguridad de las zonas y los conductos en IEC 62443, Journal of Cybersecurity and Privacy, 2026, 6(2), 52. Consultado el 18 de noviembre de 2026.
-
Claroty Team82, Congelar el controlador, descongelar los alimentos: descubrimiento de vulnerabilidades en controladores de refrigeración Danfoss, 9 de agosto de 2026. Consultado el 18 de noviembre de 2026.
-
Claroty, Cómo encontrar y proteger controladores de refrigeración expuestos a internet en instalaciones con múltiples centros, 4 de noviembre de 2026. Consultado el 18 de noviembre de 2026.
-
Midnight Blue, investigación sobre múltiples vulnerabilidades de ejecución remota de código previas a la autenticación en controladores de refrigeración, noviembre de 2026. Consultado el 18 de noviembre de 2026.
-
Centro de Ciberseguridad de Bélgica, aviso sobre seis vulnerabilidades de controladores de refrigeración recién notificadas y la reducción inmediata de la exposición, 12 de noviembre de 2026. Consultado el 18 de noviembre de 2026.