Le message essentiel. Être « maître de la situation », c’est se préparer aux erreurs et aux défaillances plutôt que supposer qu’elles ne se produiront jamais. Commencez par un inventaire et une évaluation approfondis des risques, attribuez clairement les responsabilités et mettez en place des mesures de protection éprouvées avant qu’un incident ne survienne. Des systèmes principaux sécurisés restent indispensables ; une surveillance redondante et indépendante constitue le dernier rempart pour détecter les changements physiques dommageables et donner le temps d’agir, y compris lors des coupures d’alimentation ou de connectivité auxquelles elle est conçue pour résister. Veillez à ce que la chaîne complète reste maîtrisable et adaptable à l’évolution du contexte mondial et des menaces : l’objectif est d’éviter des dommages irréversibles, pas simplement de réagir plus vite.
Synthèse
Les attaques récentes visant des installations frigorifiques administrées à distance en Europe montrent comment des cyberincidents peuvent provoquer des perturbations physiques et des pertes financières. La priorité est de prévenir les dommages par l’évaluation des risques, des mesures de protection appropriées et une réponse éprouvée, plutôt que de compter sur une indemnisation après coup. L’assurance n’est pas un filet de sécurité complet : les limites de la couverture des assurances cyber peuvent laisser des pertes sans indemnisation, selon les conditions du contrat et les circonstances de l’incident. Les mesures de protection ne peuvent garantir l’absence de pertes, et les indemnités d’assurance peuvent ne pas réparer entièrement l’atteinte à la réputation.
La leçon dépasse un fabricant, une vulnérabilité ou un secteur particuliers, mais les conséquences ne sont pas équivalentes. Dans le commerce de détail et la logistique du froid, les incidents peuvent détruire des stocks remplaçables et interrompre l’activité, sous réserve des limites d’assurance décrites ci-dessus. En FIV, la perte d’embryons de patients peut supprimer définitivement une possibilité de traitement ; dans les biobanques, la perte de décennies d’échantillons longitudinaux peut anéantir un matériel de recherche impossible à reconstituer. Dans les banques de sang, l’altération de produits cellulaires prêts à être transfusés peut compromettre leur disponibilité et la prise en charge des patients en temps utile. Ces distinctions importent partout où des équipements connectés contrôlent la température, l’humidité, la pression, la ventilation ou les concentrations de gaz, notamment dans les laboratoires, les hôpitaux, le stockage pharmaceutique, les salles propres et les environnements de production. Les dirigeants doivent évaluer les conséquences scientifiques, cliniques et opérationnelles, ainsi que la perte de confiance des clients, des patients et des partenaires, et pas seulement le coût de remplacement.
Les responsables informatiques peuvent s’appuyer sur cet article pour engager avec leur direction générale, leur directeur des services techniques ou leur comité d’audit des risques une discussion sur l’exposition, l’attribution des responsabilités et les preuves d’efficacité des protections. La responsabilité est partagée, mais externaliser l’installation ou la maintenance ne transfère pas le risque opérationnel du propriétaire des actifs. Les fabricants doivent fournir des produits sécurisés dont le support peut être assuré ; les intégrateurs doivent éviter les architectures non sûres ; et les prestataires de maintenance doivent maîtriser les accès distants privilégiés. Les clients doivent savoir ce qui est connecté, attribuer clairement les responsabilités de sécurité et traiter le cas des équipements dont le support n’est plus assuré. Ces échanges doivent déboucher sur des priorités convenues, des actions attribuées et des décisions claires sur les sujets nécessitant l’approbation de la direction. Les protections négligées doivent figurer à l’ordre du jour de la direction comme sources potentielles de pertes non assurées et d’atteinte à la réputation, et non comme de simples questions informatiques.
Même un système principal bien sécurisé peut tomber en panne, être mal configuré ou être compromis. Un inventaire et une évaluation des risques doivent identifier les processus critiques, évaluer les défaillances possibles et leurs conséquences, et définir des protections proportionnées. Pour ces processus, une surveillance redondante et indépendante doit mesurer séparément les conditions physiques, appliquer une logique d’alarme indépendante et permettre une notification, une escalade et un suivi fiables. La surveillance complète la cybersécurité préventive ; elle ne remplace pas une réponse opérationnelle éprouvée sous la responsabilité de l’établissement. L’objectif est de donner le temps d’agir avant que des écarts dommageables n’entraînent des pertes cliniques, scientifiques, opérationnelles, financières ou réputationnelles irréversibles.
Protéger les échantillons avant que la perte ne devienne irréversible. Tout laboratoire détenant des échantillons précieux, et pas seulement les laboratoires pharmaceutiques, a besoin d’une stratégie de protection fondée sur les risques. Identifiez les défaillances possibles et les conséquences de la perte d’échantillons, puis associez prévention, surveillance indépendante redondante et réponse opérationnelle éprouvée. Il ne s’agit pas simplement de déclencher une alarme, mais de donner aux personnes le temps d’agir avant que les échantillons ne soient irrémédiablement endommagés.
Un cyberincident aux conséquences physiques
Les technologies opérationnelles se distinguent de l’informatique bureautique classique parce qu’elles contrôlent des conditions physiques. Un système de contrôle-commande compromis peut modifier une température, arrêter la ventilation, neutraliser une alarme ou activer une fonction de chauffage. Les conséquences vont donc au-delà de la perte de données ou de productivité : elles peuvent menacer les produits, les échantillons irremplaçables, les soins aux patients, la recherche et la continuité d’activité.
L’administration à distance facilite le support de ces systèmes. Les techniciens peuvent diagnostiquer les défauts, ajuster les paramètres et entretenir les installations sur plusieurs sites sans se déplacer. Mais cette commodité ouvre aussi un accès à des fonctions de commande puissantes. Si une personne non autorisée accède à un contrôleur de supervision, des outils de configuration ordinaires peuvent suffire à perturber le processus. Le même accès qui permet une maintenance efficace peut ainsi devenir une source de risque physique.
Les incidents européens de réfrigération illustrent ce risque : les informations publiques décrivent des contrôleurs distants compromis et des modifications des paramètres de fonctionnement. Les autorités ont recommandé aux organisations de supprimer l’exposition directe à Internet, de vérifier l’ensemble de la configuration et les programmes de dégivrage, de mettre à jour les micrologiciels, de modifier les identifiants par défaut et de ne rétablir l’accès distant qu’au moyen d’une connexion protégée. Le problème ne se limite pas à la réfrigération commerciale ; il touche aussi les services responsables de matériel biologique essentiel à la vie.
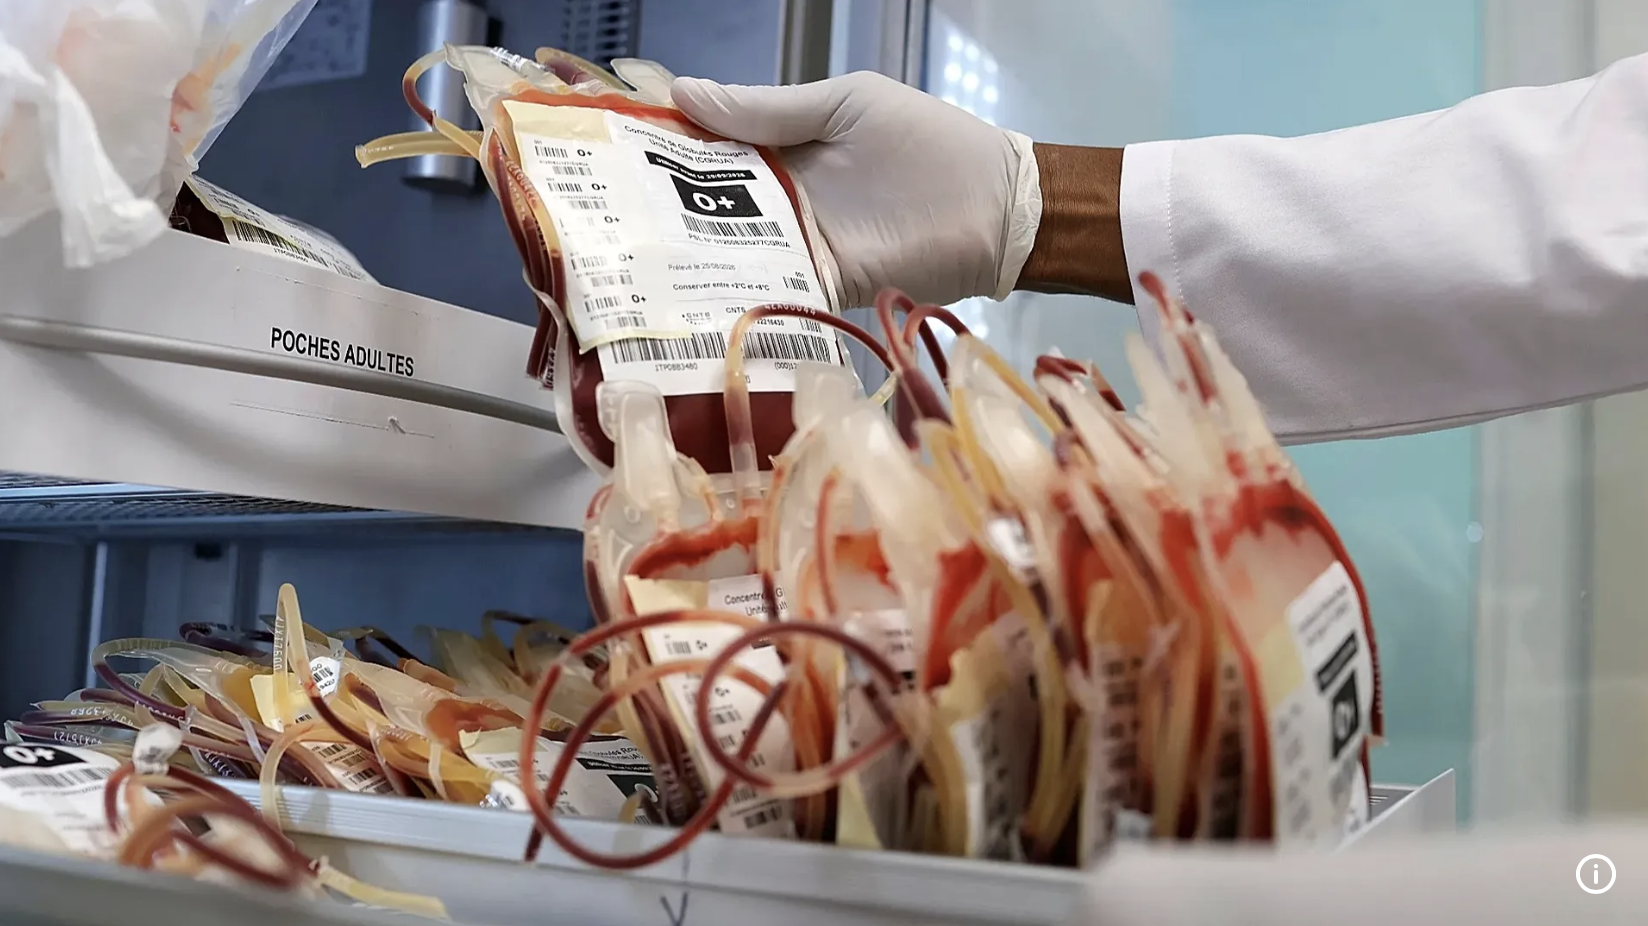
Les conséquences concernent également les services de transfusion sanguine. En France, un incident de cybersécurité touchant un fournisseur d’équipements frigorifiques a modifié les paramètres de température et de dégivrage de chambres froides de services de transfusion. La surveillance et les alarmes ont permis une intervention rapide : les produits et les échantillons ont été sécurisés ou transférés, sans perte de produits sanguins ni incidence sanitaire signalées. Au Royaume-Uni, la perturbation est survenue ailleurs dans la chaîne transfusionnelle : une cyberattaque contre des services de biologie médicale a interrompu les analyses prétransfusionnelles et les épreuves de compatibilité, augmentant le recours au sang de groupe O et contribuant à une pénurie nationale.
Ces incidents illustrent des enchaînements de défaillances différents, et non une méthode d’attaque unique ou un auteur commun, mais montrent pourquoi la protection des services de transfusion doit porter à la fois sur les conditions physiques de stockage et sur les services numériques qui assurent un approvisionnement sûr. Leur enseignement commun est que des faiblesses dans les équipements connectés, les accès fournisseurs ou l’informatique de soutien peuvent perturber les opérations. La résilience opérationnelle doit donc couvrir la chaîne complète plutôt qu’un seul appareil ou fournisseur.
Une approche fondée sur les risques doit aussi dépasser l’hypothèse d’un mobile unique. Les scénarios pertinents vont de criminels cherchant à obtenir de l’argent par extorsion au sabotage délibéré, y compris d’éventuelles motivations terroristes. La guerre hybride est un autre scénario à envisager : le Conseil de l’Union européenne identifie les cyberattaques et le sabotage comme des composantes des menaces hybrides. Ces possibilités ne constituent pas des explications confirmées des incidents décrits ici ; toute attribution exige des preuves. Quel que soit le mobile, l’exigence opérationnelle reste la même : sécuriser les accès, détecter les changements dommageables et maintenir une réponse efficace tout au long du cycle de vie du système.
La sécurité dès la conception doit perdurer en exploitation
La sécurité dès la conception est souvent présentée comme un principe de développement des produits. Pour les systèmes de contrôle-commande, elle doit aller beaucoup plus loin. Un produit sécurisé peut néanmoins devenir dangereux s’il est installé derrière un port ouvert, configuré avec des identifiants partagés, laissé avec un micrologiciel obsolète ou maintenu par une voie d’accès distant non maîtrisée. À l’inverse, une bonne segmentation réseau ne peut compenser durablement un contrôleur qui ne reçoit plus de mises à jour de sécurité.
La série IEC 62443 fournit un cadre pour sécuriser les systèmes d’automatisation et de contrôle industriels. Elle relie la sécurité des produits, l’architecture des systèmes et les responsabilités opérationnelles dans une approche de responsabilité partagée. Fabricants, intégrateurs, prestataires de services et propriétaires d’actifs doivent chacun gérer les risques qu’ils maîtrisent et coordonner la protection pendant toute la durée d’exploitation de l’installation. Ce cadre n’est donc pas simplement un ensemble de mesures réseau à appliquer après l’installation : ses principes doivent guider la conception des produits et rester intégrés à l’intégration, à l’exploitation et au support continu.
Pour les systèmes de contrôle-commande exposés à Internet ou accessibles à distance, la sécurité doit commencer dès la conception du produit, et non être ajoutée après l’installation. Négliger les principes pertinents de l’IEC 62443 peut ancrer des faiblesses dans l’authentification, la séparation des privilèges, le traitement des entrées et les mécanismes de mise à jour, que la segmentation réseau ou une exploitation prudente ne peuvent, seules, résoudre de manière fiable. La conception doit assurer une authentification forte sans secrets par défaut, partagés ou prévisibles, séparer les droits de configuration de la surveillance en lecture seule, permettre de rattacher les modifications importantes à un utilisateur individuel et fournir des mises à jour sécurisées du micrologiciel avec des périodes de support transparentes. Ces protections doivent être maintenues lors de l’intégration, de la mise en service et de l’exploitation courante. L’application des principes de l’IEC 62443 ne garantit toutefois pas un produit exempt de failles. L’administration à distance doit emprunter des voies d’accès protégées plutôt qu’une exposition directe à l’Internet public, et les risques résiduels doivent être documentés et évalués.
Zones et conduits : maîtriser les frontières de confiance
L’IEC 62443 regroupe les actifs ayant des exigences de sécurité communes dans des zones reliées par des conduits contrôlés. Une architecture illustrative distingue une zone de capteurs pour la mesure et l’acquisition, une zone de contrôle-commande pour les contrôleurs et les actionneurs, et une zone de systèmes opérationnels pour les applications de supervision et les interfaces opérateur. L’informatique bureautique et les accès de maintenance externes peuvent occuper des zones distinctes. Les conduits définissent les sources, destinations, protocoles et sens de communication autorisés, avec une application effective par des passerelles, des pare-feu ou d’autres dispositifs de contrôle aux frontières. Les connexions de mesure, de supervision et de maintenance ne doivent pas donner un accès sans restriction aux commandes. Les schémas et les étiquettes VLAN ne protègent rien à eux seuls : les frontières doivent restreindre le trafic. La segmentation limite l’exposition et la propagation d’une compromission, mais elle ne corrige pas les contrôleurs vulnérables et n’établit pas l’indépendance de la surveillance. Voir Aspects de sécurité des zones et conduits dans l’IEC 62443.
Le contournement de l’authentification et le traitement non sécurisé des entrées sont des défauts de sécurité des produits
Les incidents de réfrigération démontrent les conséquences physiques d’une commande non autorisée. Des recherches distinctes sur les vulnérabilités ont documenté des contournements d’authentification et des injections de commandes : il s’agit de défauts de sécurité des produits dans les versions concernées, et pas simplement d’erreurs de déploiement. Contourner l’authentification neutralise les contrôles d’identité ; permettre à des entrées non fiables de devenir des commandes exécutables révèle un traitement non sécurisé des entrées. Les fabricants doivent corriger ces failles ; la segmentation ne peut remplacer des produits sécurisés. La protection exige une authentification et une autorisation sur chaque voie d’accès privilégié, une validation des entrées côté serveur et une séparation entre données et instructions exécutables. Ces recherches établissent des défauts de conception ou d’implémentation, pas la voie d’exploitation utilisée dans chaque attaque. Des micrologiciels à jour, des accès maîtrisés et des protections vérifiées restent nécessaires.
Les recherches de Midnight Blue de novembre 2026 renforcent cette distinction : les chercheurs ont signalé plusieurs vulnérabilités permettant l’exécution de code à distance sans authentification dans des contrôleurs frigorifiques, y compris dans le micrologiciel le plus récent qu’ils avaient évalué à cette date. La seule mise à jour du micrologiciel ou modification des mots de passe ne permet donc pas d’établir qu’un système exposé est sécurisé. L’exposition directe à Internet doit être supprimée sans attendre les correctifs, tandis que les mises à jour de sécurité disponibles restent une composante de la maintenance maîtrisée du cycle de vie. Ces constats renforcent la nécessité d’une conception sécurisée des produits et d’un accès distant restreint.
Du cadre au cycle de vie : maintenir la protection à chaque étape
Ces principes rendent nécessaire un modèle de cycle de vie : une conception sécurisée pose les bases, mais la protection peut être affaiblie par les choix d’installation, les changements de configuration, l’accès distant ou la fin du support de sécurité. Un modèle de sécurité crédible doit donc couvrir la conception du produit, l’intégration, la vérification et la validation, la mise en service, le support à distance, les correctifs et mises à jour, la réponse aux incidents et le remplacement à terme. Ces activités sont des responsabilités liées entre elles, et non une liste de contrôle ponctuelle achevée à la réception. Sur l’ensemble du cycle de vie, les principes élémentaires de sécurité informatique, l’attribution claire des responsabilités et les protections coordonnées doivent rester en place pour que l’installation demeure sécurisée, maintenable et maîtrisable malgré l’évolution du contexte.
Figure 1 : Modèle de sécurité du cycle de vie des systèmes de contrôle-commande.
Où les organisations échouent, et à quel prix
Le fabricant : des fonctionnalités sans cycle de vie sécurisé
Le fabricant crée la première ligne de défense. La faiblesse commence lorsque la facilité de maintenance à distance prime sur une architecture sécurisée, ou lorsqu’un appareil comporte des mécanismes d’accès non documentés, des contrôles d’identité faibles ou une journalisation insuffisante. Elle apparaît aussi lorsque les mises à jour sont difficiles à déployer ou que le support prend fin sans trajectoire de migration réaliste.
Les conséquences peuvent largement dépasser un seul appareil. Un contrôleur de supervision peut gérer de nombreux actifs connectés, et un produit courant est souvent déployé de la même manière sur de nombreux sites. Une faiblesse peut donc se reproduire. Les fabricants doivent être jugés non seulement sur le fonctionnement actuel de l’équipement, mais aussi sur sa capacité à rester sécurisé, à être mis à jour et à bénéficier d’un support pendant toute sa durée d’exploitation prévue.
Les fabricants ont une responsabilité particulière, car les clients ne perçoivent pas nécessairement quand la commodité, les économies ou des paramètres par défaut faibles dissimulent des compromis de sécurité. Le manque d’expertise technique d’un client ne doit pas servir d’excuse à une conception non sécurisée ou à des engagements de support imprécis. Le règlement européen sur la cyberrésilience (CRA), règlement (EU) 2024/2847, impose aux fabricants de produits entrant dans son champ d’application des responsabilités en matière d’évaluation des risques, de sécurité dès la conception et par défaut, d’instructions claires aux utilisateurs, de période de support déclarée et de traitement des vulnérabilités pendant cette période. Cela renforce le principe selon lequel les clients ne devraient pas avoir à découvrir des faiblesses cachées avant que les fabricants ne les corrigent. Les principales obligations du CRA s’appliquent à compter du 11 décembre 2027, tandis que les obligations de notification s’appliquent depuis le 11 septembre 2026. L’applicabilité doit être vérifiée pour chaque produit, y compris les exclusions pertinentes ; le CRA ne supprime pas la responsabilité du client en matière d’exploitation sécurisée.
Le propriétaire des actifs : conserver l’équipement parce qu’il fonctionne encore
Un équipement qui fonctionne n’est pas nécessairement sécurisé. Un contrôleur peut réguler correctement la température alors que son modèle de sécurité est obsolète. Pour les équipements en réseau qui influent sur des processus critiques, la fin du support de sécurité doit déclencher un remplacement, un isolement ou une dérogation de courte durée formellement approuvée, assortie de mesures compensatoires.
« Cela fonctionne chez moi depuis vingt ans. Pourquoi changer une solution qui marche ? » Cette objection illustrative confond fiabilité passée et protection actuelle. L’équipement peut rester inchangé alors que les menaces évoluent rapidement. Son maintien doit dépendre de l’adéquation de la connectivité, du support et des protections, étayée par une décision documentée sur le risque, et non de sa seule longévité.
Les conséquences d’un retard ne se mesurent pas uniquement par une dépréciation des stocks. Les marchandises du commerce de détail peuvent être remplacées, même si les interruptions d’activité et les lacunes d’assurance subsistent. Les embryons de patients et les échantillons longitudinaux uniques de biobanques peuvent être totalement irremplaçables. La perte de composants sanguins utilisables peut empêcher des soins transfusionnels en temps utile. Les propriétaires d’actifs doivent donc évaluer les pertes irréversibles, les perturbations des traitements et les conséquences scientifiques, et pas seulement la valeur inscrite au registre des actifs ou l’indemnisation potentielle.
L’intégrateur : quand la maintenance à distance devient une exposition publique
Fabricants et intégrateurs peuvent appartenir à une même organisation ou à des entreprises distinctes. Dans les deux cas, les deux responsabilités s’appliquent : expliquer les capacités et les limites de sécurité du produit, et livrer une installation sécurisée. Des fournisseurs distincts ajoutent des interfaces et des passages de relais ; aucune partie ne peut supposer que l’autre prend en charge un risque non résolu.
L’exposition publique, des redirections de ports étendues, des mots de passe réutilisés et des règles de pare-feu non documentées peuvent compromettre un produit pourtant performant. La réception doit s’accompagner d’une documentation de l’architecture, des flux de données, des permissions, de la configuration de sécurité, de la journalisation, des responsabilités de mise à jour et de l’isolement sécurisé, en précisant au client qui est habilité à accéder au système et à le modifier.
De la conception à l’exploitation, l’intégrateur et le prestataire informatique interne ou externe du client doivent convenir de la segmentation, de l’accès distant protégé, des comptes individuels, des approbations, de la journalisation, de la surveillance et de l’intégration à la réponse aux incidents. Les contrôles doivent assurer la cybersécurité sans perturber les opérations critiques.
Après la réception, le client, l’intégrateur et le prestataire informatique doivent tenir à jour la documentation et l’attribution des responsabilités concernant les changements, les mises à jour, les revues d’accès, le rétablissement et le remplacement, en associant le fabricant si nécessaire. Toute modification de l’équipement ou de l’environnement informatique doit déclencher une revue coordonnée pour préserver la sécurité et la capacité de support sur le cycle de vie.
Le prestataire de maintenance : un accès distant sans responsabilité équivalente
La maintenance à distance accorde un accès privilégié aux processus physiques. Les techniciens peuvent connaître les équipements sans être spécialistes de la cybersécurité ; les prestataires doivent donc rendre le travail sécurisé praticable grâce à des outils accessibles, des formations et des procédures. Les contrôles doivent protéger les installations sans entraver la maintenance courante ni les interventions urgentes.
Utilisez des comptes nominatifs, une authentification forte, des permissions définies et des sessions journalisées. Prévoyez un accès d’urgence contrôlé plutôt que de contourner les protections. Avec le prestataire informatique du client, veillez à ce que les accès puissent être accordés, réexaminés et révoqués efficacement, y compris pour les sous-traitants. La sécurité doit réduire le risque global sans créer de problèmes opérationnels plus importants.
Pour les organisations entrant dans le champ de NIS2, l’accès de maintenance de tiers constitue aussi un enjeu de conformité de la chaîne d’approvisionnement. L’article 21 exige que la gestion des risques de cybersécurité couvre les fournisseurs et prestataires directs, les contrôles d’accès et l’efficacité des mesures de protection. Un accès distant non maîtrisé ou non surveillé peut donc constituer une lacune de conformité grave, selon le droit national applicable et le profil de risque de l’organisation. Les contrats de maintenance devraient définir l’approbation des accès, l’authentification, la journalisation, la surveillance, la révocation et les responsabilités en cas d’incident, avec des preuves du fonctionnement réel de ces contrôles.
Informatique interne, services techniques et direction : des failles entre les responsabilités
Les équipements connectés de réfrigération, de chauffage, ventilation et climatisation (CVC) et de laboratoire relèvent à la fois de l’informatique, des services techniques, de la qualité et de l’exploitation. Le personnel peut comprendre leur fonction tout en négligeant les dépendances réseau, les risques d’accès distant ou les besoins de support. Lorsque l’informatique n’y voit que des équipements techniques, que les services techniques font confiance au fournisseur et que la qualité se concentre sur la conformité, des protections essentielles peuvent se retrouver sans responsable de bout en bout.
La direction doit attribuer les responsabilités et réunir les équipes internes et les prestataires autour d’une gestion partagée des risques, de dépendances clairement définies et de circuits d’escalade. Externaliser des tâches ne transfère pas la responsabilité du risque opérationnel. Les équipements sans support, les responsabilités floues et les accès fournisseurs non vérifiés doivent rester visibles ; les décisions de remplacement et de surveillance indépendante doivent refléter les conséquences d’une défaillance, et pas seulement sa probabilité ou le prix d’achat.
Figure 2 : Relations et responsabilités partagées entre toutes les parties prenantes.
Gérer une coordination de plus en plus complexe entre fournisseurs
À mesure que le nombre de parties prenantes augmente, la mise en œuvre et le maintien d’une solution fiable deviennent un défi de coordination plus important. Chaque partie supplémentaire introduit des interfaces, des dépendances, des étapes d’approbation et de possibles lacunes de responsabilité. Un changement simple au sein d’une organisation peut nécessiter l’accord de plusieurs fournisseurs, ce qui ralentit la réponse lorsque le contexte mondial, les menaces ou les exigences opérationnelles évoluent rapidement. Une solution doit donc être jugée non seulement sur le fonctionnement de ses composants individuels, mais aussi sur la possibilité de gérer, tester et adapter la chaîne complète dans le temps disponible.
Les organisations devraient donc envisager de réduire les passages de relais inutiles entre fournisseurs et de sélectionner des prestataires capables de coordonner de bout en bout la chaîne de résilience opérationnelle, plutôt que de gérer des composants isolés. Dans un périmètre contractuel clairement défini, le prestataire devrait assumer la responsabilité de fournir et de maintenir les protections convenues pour la conception, l’intégration, la surveillance, la maintenance, l’escalade et le rétablissement. Le client conserve la responsabilité de l’acceptation des risques, des décisions opérationnelles et de la réponse humaine. L’objectif est de réduire les lacunes entre ces activités, avec une autorité claire pour coordonner rapidement les changements.
Cela ne signifie ni exclure des parties prenantes essentielles, ni supposer qu’un fournisseur unique supprime tout risque. La consolidation des fournisseurs et l’indépendance de la surveillance répondent à des questions différentes : réduire les passages de relais peut simplifier la coordination, tandis que des mesures et une évaluation des alarmes séparées, ainsi que des dispositifs d’alimentation et de communication suffisamment indépendants, réduisent les risques de défaillance commune. Toute solution consolidée doit démontrer cette indépendance, préserver la transparence des responsabilités et la supervision du client, et inclure un plan crédible de continuité et de sortie. L’objectif est une organisation plus simple, aux responsabilités mieux définies, qui reste fiable au quotidien et adaptable lorsque les circonstances changent.
Pourquoi la prévention seule ne suffit pas
Une bonne cybersécurité réduit la probabilité de compromission, mais ne peut garantir qu’elle ne surviendra jamais. Des identifiants peuvent être volés, un fournisseur de confiance compromis, une erreur de configuration peut exposer un système et un technicien légitime peut effectuer une modification dommageable. De nouvelles vulnérabilités peuvent exister avant qu’un correctif soit disponible. Même une mise à jour sécurisée peut produire un effet opérationnel inattendu.
Une conception résiliente examine donc simultanément deux questions. Comment empêcher les accès non autorisés ? Et comment détecter la conséquence physique si, malgré tout, un problème touche l’accès, la configuration ou la commande ? La première question relève de la sécurité préventive. La seconde exige une source de vérité indépendante.
Une distinction cruciale. Une alarme produite par le contrôleur même qui est manipulé ne constitue pas une couche de protection pleinement indépendante. Une indépendance réelle exige une mesure séparée, une évaluation séparée et, lorsque cela est approprié, une alimentation et une voie de communication séparées.
La surveillance indépendante comme seconde source de vérité
Voie de contrôle-commande et voie de surveillance indépendante, côte à côte.
La surveillance indépendante fournit une seconde source de vérité en mesurant les conditions physiques séparément du contrôleur principal et en appliquant des seuils d’alarme gérés indépendamment. L’incident affectant les services de transfusion français décrit plus haut démontre la valeur pratique de la surveillance, des alarmes et d’une intervention en temps utile : les produits et les échantillons ont été sécurisés ou transférés, sans perte de produits sanguins ni incidence sanitaire signalées. Ce résultat plaide pour une alerte efficace, mais n’établit pas à lui seul l’indépendance architecturale ou la redondance des systèmes concernés.
Une surveillance efficace doit rester disponible pendant les défaillances qu’elle est censée révéler. Un incident de plus grande ampleur peut interrompre la connectivité Internet ou l’alimentation de tout un établissement, désactivant potentiellement à la fois les équipements principaux et leur chaîne d’alarme. La surveillance indépendante nécessite donc une redondance suffisante pour préserver l’alerte et l’escalade dans les scénarios de perturbation identifiés par l’évaluation des risques. Elle ne peut ni empêcher l’attaque initiale ni maintenir à elle seule le fonctionnement des équipements contrôlés.
La redondance doit couvrir toute la chaîne de surveillance, et ne pas s’arrêter à un capteur ou à un tableau de bord supplémentaire. L’évaluation des risques doit définir les scénarios de perturbation et la durée de fonctionnement autonome auxquels le système est conçu pour résister, ainsi que les dispositions nécessaires pour maintenir la mesure, l’évaluation locale des alarmes, la mise en mémoire tampon des données, l’alimentation de secours et les voies de communication alternatives. Une voie de secours ne doit pas dépendre de la même connexion ou source d’alimentation dont elle est censée couvrir la défaillance. Les mêmes principes de conception sécurisée et de gestion du cycle de vie s’appliquent : le système doit être entretenu, mis à jour et testé, notamment par des exercices supprimant l’alimentation normale et l’accès Internet et vérifiant que les alarmes atteignent toujours des personnes capables d’agir. Ces mesures offrent la possibilité d’intervenir à temps ; elles ne garantissent pas que toute perte pourra être évitée. Les limites résiduelles doivent être comprises et acceptées dans le cadre de l’évaluation des risques.
Un modèle d’exploitation plus mature
Un modèle d’exploitation mature commence par un inventaire et une évaluation approfondis des risques, et non par l’achat d’équipements ou l’hypothèse que les protections existantes suffisent. Les organisations doivent identifier les processus critiques, les échantillons précieux et les actifs connectés ; comprendre leurs dépendances à l’alimentation, aux réseaux et aux fournisseurs ; et évaluer les conséquences d’une défaillance ou d’une compromission. L’évaluation doit établir quels risques nécessitent une action, qui en est responsable et quel niveau de protection et de continuité est nécessaire. Elle fonde les décisions relatives à la connectivité sécurisée, au remplacement des équipements, à la surveillance indépendante et à la réponse humaine.
Lorsque les clients ne disposent pas de l’expertise, des ressources ou des capacités nécessaires pour mener eux-mêmes ce travail, ils devraient faire appel à une entreprise spécialisée disposant de références démontrables et capable d’évaluer leur environnement opérationnel. Le choix devrait reposer sur une expérience pertinente, une méthode d’évaluation claire et la preuve que le prestataire peut traduire les constats en protections pratiques et maîtrisables, et pas simplement recommander des produits. Le travail doit associer les équipes d’exploitation, d’informatique, des services techniques et de qualité du client afin de comprendre ensemble les dépendances techniques et les conséquences de la perte d’échantillons ou de services. Le soutien externe renforce l’évaluation ; il ne transfère pas la responsabilité du client en matière d’acceptation et de gestion des risques.
Le résultat doit être un plan d’action documenté et hiérarchisé, avec des responsabilités claires, des délais convenus et un financement. Il doit traiter l’exposition distante, les contrôles d’accès, l’état des micrologiciels et du support, les responsabilités des fournisseurs, l’isolement sécurisé ainsi que l’indépendance et la redondance de la surveillance. Les protections doivent ensuite être vérifiées au moyen de tests de la chaîne d’alarme, d’exercices de réponse hors horaires ouvrés et de contrôles en cas de perte de l’alimentation ou de la connectivité normales. L’inventaire et l’évaluation des risques sont des responsabilités continues : ils doivent être réexaminés lorsque les équipements, les fournisseurs, la connectivité ou les menaces changent, afin que la protection reste adaptée à l’environnement opérationnel réel.
XiltriX Resilience soutient la résilience opérationnelle
XiltriX Resilience est conçu pour soutenir la résilience opérationnelle en fournissant une couche de surveillance indépendante dans les environnements critiques. Sa contribution associe infrastructure physique, intelligence de surveillance et accompagnement continu, plutôt que de reposer sur un capteur ou une fonctionnalité logicielle unique. Ces éléments favorisent la détection, la notification et le suivi, mais une protection efficace dépend aussi de la sécurité des systèmes principaux du client, de ses décisions en matière de risques et de sa réponse humaine. Technologie et services doivent fonctionner ensemble dans ce modèle de responsabilité partagée.
Infrastructure : mesurer la réalité physique
Des stations de surveillance et des capteurs dédiés créent une voie de mesure extérieure à la logique de commande principale. Selon l’application, elle peut couvrir la température, l’humidité, la pression différentielle, l’oxygène, le dioxyde de carbone, l’état des portes, les contacts d’alarme des équipements, l’état de l’alimentation et le bon fonctionnement des communications. La mise en mémoire tampon locale et le fonctionnement sur batterie contribuent à préserver les éléments probants et la visibilité pendant les perturbations.
De la mesure physique à la réponse appropriée
-
Des capteurs indépendants mesurent les conditions dans les incubateurs, les réfrigérateurs, les locaux et les stockages cryogéniques.
-
Des stations de surveillance dédiées assurent une mise en mémoire tampon locale et un fonctionnement sur batterie.
-
Un hébergement cloud sécurisé prend en charge les données de surveillance, le SSO et l’API REST.
-
Les écarts environnementaux suivent le circuit de notification et d’escalade défini par le client vers l’équipe de l’établissement.
-
Les défauts du système de surveillance sont transmis au support technique XiltriX ; le support technique à distance 24 h/24 et 7 j/7 relève d’Intelligence.
Figure 3 : Les capacités de XiltriX Resilience (www.xiltrix.com)
Intelligence : détecter et communiquer ce qui compte
La couche logicielle évalue les mesures en continu, gère les seuils d’alarme et fournit des tableaux de bord, des notifications, une escalade, des rapports d’incident et des preuves de conformité. Le diagnostic à distance et la surveillance de l’état du système aident à distinguer les écarts environnementaux des problèmes de capteur, d’alimentation ou de communication. La plateforme de surveillance nécessite aussi un hébergement cloud sécurisé et une gestion continue du cycle de vie logiciel afin de continuer à bénéficier d’un support plutôt que de devenir un système ancien non maîtrisé.
Intelligence comprend les mises à jour logicielles et les mises à jour OTA des micrologiciels, ainsi qu’un support technique à distance 24 h/24 et 7 j/7 pour le système de surveillance lui-même. Le client reste responsable de la réponse aux alarmes environnementales et aux alarmes des équipements.
Care : services sur site
Care couvre les services sur site : installation par des partenaires accompagnés par XiltriX, mise en service, validation, formation, étalonnage et maintenance.
Responsabilités de surveillance technique et réponse du client
XiltriX est responsable de la chaîne technique de surveillance, notamment de la mesure, de l’enregistrement des données, de la génération des alarmes et de l’acheminement technique des notifications dans le périmètre de service convenu. Les défauts du système de surveillance sont pris en charge par le support technique XiltriX. L’équipe de l’établissement ou du client reste responsable de la tenue à jour des contacts d’alarme et des procédures de réponse, de l’acquittement des alarmes opérationnelles, de l’évaluation de leur importance et des actions menées en temps utile pour protéger les échantillons, les produits et les patients. L’acheminement technique d’une alarme ne constitue pas une intervention opérationnelle.
La surveillance XiltriX ajoute-t-elle une surface d’attaque ?
La configuration de surveillance XiltriX sépare la mesure de la commande : des capteurs Pt1000, des signaux 4–20 mA et des entrées à contacts secs captent les conditions physiques indépendamment de la boucle de commande principale ou des automates programmables industriels (PLC). Dans cette configuration, aucune connexion vers un actionneur ou permettant l’écriture dans un contrôleur n’est fournie : la surveillance ne peut pas modifier les consignes à distance ni arrêter les groupes frigorifiques. La télémétrie chiffrée utilise des connexions initiées en sortie, sans nécessiter de ports entrants sur le pare-feu ni de redirection de ports. Les options de déploiement comprennent un VLAN dédié segmenté par pare-feu ou une voie exclusivement cellulaire séparée du réseau de l’établissement, et non un véritable isolement physique (« air gap »). L’équipe informatique/sécurité du client doit vérifier les flux de données déployés, l’isolement et l’absence de voies de commande avant approbation.
Remarque importante. XiltriX Resilience ne doit pas être présenté comme une raison de tolérer un contrôleur principal non sécurisé. C’est une couche de défense en profondeur qui réduit la dépendance à un contrôleur, un réseau, une voie de communication ou une organisation de services uniques. L’environnement principal doit néanmoins être sécurisé, corrigé et remplacé à la fin de son support.
Les questions auxquelles les dirigeants devraient savoir répondre
Les dirigeants de toutes les entreprises doivent être « maîtres de la situation », et pas seulement ceux des environnements pharmaceutiques ou d’autres secteurs fortement réglementés. Cela signifie comprendre les risques courus par l’organisation, les conséquences des défaillances et les options d’atténuation disponibles pour réduire ces risques. Cela n’exige ni la maîtrise de chaque détail technique ni l’élimination de tout risque. Cela exige un inventaire et une évaluation des risques à jour, des décisions éclairées sur des protections proportionnées, des responsabilités claires et des preuves du fonctionnement de ces protections. Les dirigeants doivent comprendre le risque subsistant après atténuation et décider explicitement s’il est acceptable.
Le test « Savoir, joindre, agir » : si le contrôleur principal était compromis et que l’alimentation normale et l’accès Internet tombaient en panne, pourrions-nous connaître les conditions physiques de manière indépendante, joindre une personne responsable et agir avant des dommages irréversibles ? Réussir ce test exige une mesure indépendante démontrée, un circuit de notification et d’escalade testé, ainsi qu’une réponse sous la responsabilité de l’établissement, exécutée dans le temps disponible selon le scénario évalué. Une alarme seule ne suffit pas.
Les questions essentielles sont pratiques : quels systèmes connectés peuvent affecter un processus critique, et qui peut y accéder ? Chaque accès fait-il l’objet d’une authentification individuelle et d’une journalisation ? Quand le support de sécurité prend-il fin, et l’équipement peut-il être isolé en toute sécurité ? Que se passe-t-il si l’alimentation, la connectivité Internet ou un fournisseur clé devient indisponible ? Quels contrôles préventifs, quelle surveillance indépendante et quelles dispositions de rétablissement peuvent limiter les conséquences, et qui intervient hors horaires ouvrés ? Lorsque l’expertise manque, les dirigeants devraient obtenir un soutien qualifié tout en conservant leur rôle de supervision. Être « maître de la situation », c’est pouvoir expliquer ces choix et démontrer leur mise en œuvre effective, et non simplement supposer que l’informatique ou un fournisseur s’est occupé de tout.
La législation européenne sur la cybersécurité donne une dimension juridique à cette responsabilité pour les organisations entrant dans son champ d’application. L’article 20 de la directive NIS2 exige que les États membres veillent à ce que les organes de direction des entités essentielles et importantes approuvent les mesures de gestion des risques de cybersécurité, supervisent leur mise en œuvre et puissent être tenus responsables des manquements à ces obligations. Il exige aussi que les membres des organes de direction suivent une formation. Les obligations et les mécanismes de responsabilité applicables doivent être vérifiés au regard du droit national de transposition ; ces dispositions ne s’appliquent pas indistinctement à toutes les entreprises.
Le règlement sur la cyberrésilience (CRA), règlement (EU) 2024/2847, établit séparément des responsabilités de sécurité des produits pour les fabricants de produits entrant dans son champ d’application, notamment l’évaluation des risques, la sécurité dès la conception et par défaut, et le traitement des vulnérabilités pendant la période de support déclarée. Les dirigeants des fabricants concernés doivent veiller à ce que leur organisation puisse assumer ces responsabilités ; le CRA ne doit pas être présenté comme imposant le même régime de responsabilité personnelle des dirigeants que NIS2. Les obligations de notification du CRA s’appliquent depuis le 11 septembre 2026 ; ses principales obligations s’appliquent à compter du 11 décembre 2027. Les dirigeants devraient déterminer quelles règles s’appliquent à leur organisation et à leurs produits et obtenir un avis juridique si nécessaire. Le principe général de gestion reste pertinent pour toute entreprise : comprendre l’exposition, choisir des mesures d’atténuation appropriées et conserver les preuves d’une supervision éclairée.
Conclusion
Les incidents européens de réfrigération ne justifient pas d’attendre la prochaine alerte. Ils révèlent comment l’accès distant, les équipements anciens et la fragmentation des responsabilités peuvent transformer une compromission numérique en pertes physiques. La pression devrait s’intensifier : le National Cyber Security Centre britannique estime que l’IA augmentera presque certainement la fréquence et l’intensité des cybermenaces, le volume et l’impact des intrusions étant très susceptibles de croître d’ici 2027. À mesure que les attaques deviennent plus fréquentes et plus efficaces, les organisations risquent d’être dépassées par les efforts nécessaires pour détecter, coordonner et répondre. Compter sur des personnes pour réagir plus vite après chaque incident n’est pas une stratégie de protection durable.
Les dirigeants de toutes les entreprises doivent être « maîtres de la situation » avant qu’un incident ne commence. Cela exige un inventaire et une évaluation des risques à jour, des décisions explicites sur les mesures d’atténuation et des responsabilités claires entre fabricants, intégrateurs, prestataires de maintenance et équipes internes. Les équipements sans support et les accès fournisseurs mal définis doivent être traités, et non tolérés parce que l’installation fonctionne encore. Lorsque l’expertise manque, un soutien qualifié doit être mobilisé. L’objectif est de réduire l’exposition et de supprimer les délais évitables avant qu’un changement dommageable n’exige une réponse urgente.
Même alors, la prévention ne peut être la seule barrière entre une attaque et des dommages irréversibles. La surveillance indépendante constitue le dernier rempart pour détecter les changements physiques dommageables, et ses dispositifs d’alimentation, de communication et d’escalade doivent résister aux défaillances qu’elle est censée révéler. Ces dispositifs doivent être testés avec les personnes habilitées à agir. À mesure que la pression des attaques augmente, chaque délai évitable consomme du temps qui pourrait être nécessaire pour protéger les échantillons, les produits et les services. La résilience doit être conçue, entretenue et exercée à l’avance : une fois les dommages physiques commencés, il peut ne pas y avoir de seconde chance.
Pour conclure. La résilience opérationnelle part de l’hypothèse que des défaillances surviendront. Elle exige des mesures d’atténuation éprouvées, conçues pour détecter les problèmes tôt, limiter leurs conséquences et donner le temps d’agir avant que des dommages irréversibles ne se produisent. Ces protections doivent rester adaptables alors que le contexte mondial, les menaces et les exigences opérationnelles évoluent rapidement.
Références
-
Wikipedia, Technologies opérationnelles (définition générale). Consulté le 5 novembre 2026.
-
CERT-FR, CERTFR-2026-ALE-012, Incident de sécurité ciblant les contrôleurs à distance des installations de réfrigération, 12 octobre 2026, mis à jour le 16 octobre 2026. Consulté le 18 novembre 2026.
-
Série EN IEC 62443 : partie 4-1, Exigences relatives au cycle de vie de développement sécurisé des produits ; partie 2-4, Exigences relatives au programme de sécurité des prestataires de services IACS ; et partie 3-3, Exigences de sécurité des systèmes et niveaux de sécurité. Présentation complémentaire : NEN, IEC 62443 : cybersécurité industrielle. Consulté le 5 novembre 2026.
-
Directive (EU) 2022/2555 (NIS2), articles 20–21 : gouvernance et mesures de gestion des risques de cybersécurité. Consulté le 5 novembre 2026.
-
Commission européenne, Règlement sur la cyberrésilience – Fabricants et Règlement sur la cyberrésilience : calendrier d’application. Consulté le 5 novembre 2026.
-
National Cyber Security Centre britannique, Impact de l’IA sur la cybermenace d’aujourd’hui à 2027, 2025. Consulté le 5 novembre 2026.
-
Établissement français du sang (EFS), communiqué sur l’incident de cybersécurité touchant un fournisseur d’équipements frigorifiques, novembre 2026. Consulté le 5 novembre 2026.
-
NHS England – London, Dernier communiqué de presse sur la cyberattaque contre Synnovis. Consulté le 5 novembre 2026.
-
Conseil de l’Union européenne, Menaces hybrides. Consulté le 5 novembre 2026.
-
NIS2 Info, Directive NIS2 : article 20 – Gouvernance (reproduction secondaire de la disposition ; la directive officielle figure ci-dessus). Consulté le 5 novembre 2026.
-
NU.nl, article sur les cyberattaques visant la réfrigération et la couverture d’assurance des stocks avariés (lien dans la synthèse).
-
XiltriX International, site de l’entreprise (lien dans la figure 3).
-
Jaatun et al., Aspects de sécurité des zones et conduits dans l’IEC 62443, Journal of Cybersecurity and Privacy, 2026, 6(2), 52. Consulté le 18 novembre 2026.
-
Claroty Team82, Geler le contrôleur, dégivrer les aliments : découverte de vulnérabilités dans les contrôleurs frigorifiques Danfoss, 9 août 2026. Consulté le 18 novembre 2026.
-
Claroty, Comment repérer et sécuriser les contrôleurs frigorifiques exposés à Internet dans les installations multisites, 4 novembre 2026. Consulté le 18 novembre 2026.
-
Midnight Blue, recherches sur plusieurs vulnérabilités d’exécution de code à distance avant authentification dans des contrôleurs frigorifiques, novembre 2026. Consulté le 18 novembre 2026.
-
Centre pour la Cybersécurité Belgique, avis sur six vulnérabilités de contrôleurs frigorifiques récemment signalées et la réduction immédiate de l’exposition, 12 novembre 2026. Consulté le 18 novembre 2026.