De kernboodschap. ‘In Control’ zijn betekent voorbereid zijn op fouten en storingen, in plaats van aan te nemen dat ze nooit zullen optreden. Begin met een grondige risico-inventarisatie en -beoordeling, wijs duidelijke verantwoordelijkheden toe en tref geteste beschermingsmaatregelen voordat zich een incident voordoet. Veilige primaire systemen blijven essentieel; redundante, onafhankelijke monitoring vormt de laatste verdedigingslinie om schadelijke fysieke veranderingen te detecteren en tijd te creëren om in te grijpen, ook tijdens stroom- of verbindingsuitval waartegen de monitoring bestand is ontworpen. Houd de volledige keten beheersbaar en aanpasbaar wanneer mondiale omstandigheden en dreigingen veranderen: het doel is onomkeerbare schade te voorkomen, niet alleen sneller te reageren.
Managementsamenvatting
Recente aanvallen op op afstand beheerde koelinstallaties in Europa laten zien hoe cyberincidenten fysieke verstoringen en financiële verliezen kunnen veroorzaken. De prioriteit is schade voorkomen met risicobeoordeling, passende beschermingsmaatregelen en een geteste respons, niet vertrouwen op schadevergoeding achteraf. Een verzekering is geen volledig vangnet: beperkingen in de dekking van cyberverzekeringen kunnen ertoe leiden dat schade onverzekerd blijft, afhankelijk van de polisvoorwaarden en de omstandigheden van het incident. Beschermingsmaatregelen bieden geen garantie dat verliezen worden voorkomen, en verzekeringsuitkeringen kunnen reputatieschade mogelijk niet volledig herstellen.
De les reikt verder dan één fabrikant, kwetsbaarheid of sector, maar de gevolgen zijn niet onderling uitwisselbaar. Incidenten in de detailhandel en gekoelde logistiek kunnen vervangbare voorraden vernietigen en de bedrijfsvoering onderbreken, met inachtneming van de hierboven beschreven verzekeringsbeperkingen. Bij IVF kan het verlies van embryo’s van patiënten een behandelmogelijkheid definitief wegnemen; bij biobanken kan het verlies van decennia aan longitudinaal verzamelde monsters onderzoeksmateriaal vernietigen dat niet opnieuw kan worden verkregen. Bij bloedbanken kunnen aangetaste, voor transfusie gereedstaande cellulaire producten de beschikbaarheid en tijdige patiëntenzorg in gevaar brengen. Deze verschillen zijn relevant overal waar verbonden hardware temperatuur, luchtvochtigheid, druk, ventilatie of gasconcentraties regelt, waaronder laboratoria, ziekenhuizen, farmaceutische opslag, cleanrooms en productieomgevingen. Leidinggevenden moeten wetenschappelijke, klinische en operationele gevolgen beoordelen, samen met verlies van vertrouwen bij klanten, patiënten en partners, in plaats van uitsluitend naar vervangingskosten te kijken.
IT-leidinggevenden kunnen dit artikel gebruiken om met de directie, de facilitair directeur of de risico- en auditcommissie in gesprek te gaan over blootstelling aan risico’s, eigenaarschap en bewijs dat beschermingsmaatregelen werken. De verantwoordelijkheid is gedeeld, maar het uitbesteden van installatie of onderhoud draagt het operationele risico van de eigenaar niet over. Fabrikanten moeten veilige producten leveren die ondersteund kunnen worden; integratoren moeten onveilige architecturen vermijden; en onderhoudspartijen moeten geprivilegieerde toegang op afstand beheersen. Klanten moeten weten wat er is aangesloten, duidelijke beveiligingsverantwoordelijkheden toewijzen en apparatuur aanpakken die niet meer wordt ondersteund. Deze gesprekken moeten leiden tot overeengekomen prioriteiten, toegewezen acties en duidelijke besluiten over zaken waarvoor goedkeuring van het management nodig is. Verwaarloosde beschermingsmaatregelen horen op de bestuurlijke agenda als mogelijke bronnen van onverzekerde verliezen en reputatieschade, niet uitsluitend als IT-vraagstukken.
Zelfs een goed beveiligd primair systeem kan uitvallen, verkeerd worden geconfigureerd of worden gecompromitteerd. Een risico-inventarisatie en -beoordeling moet kritieke processen identificeren, mogelijke storingen en hun gevolgen evalueren en proportionele beschermingsmaatregelen vaststellen. Voor deze processen moet redundante, onafhankelijke monitoring fysieke omstandigheden afzonderlijk meten, onafhankelijke alarmlogica toepassen en betrouwbare meldingen, escalatie en opvolging ondersteunen. Monitoring vult preventieve cybersecurity aan; zij vervangt geen geteste operationele respons waarvoor de locatie zelf verantwoordelijk is. Het doel is tijd te creëren om in te grijpen voordat schadelijke afwijkingen leiden tot onomkeerbare klinische, wetenschappelijke, operationele, financiële of reputatieschade.
Bescherm monsters voordat verlies onomkeerbaar wordt. Elk laboratorium met waardevolle monsters, niet alleen farmaceutische laboratoria, heeft een risicogebaseerde beschermingsstrategie nodig. Breng mogelijke storingen en de gevolgen van monsterverlies in kaart en combineer vervolgens preventie, redundante onafhankelijke monitoring en een geteste operationele respons. Het doel is niet alleen alarm slaan, maar mensen tijd geven om in te grijpen voordat monsters onherstelbaar beschadigd raken.
Een cyberincident met fysieke gevolgen
Operationele technologie verschilt van conventionele kantoor-IT doordat zij fysieke omstandigheden regelt. Een gecompromitteerd besturingssysteem kan een temperatuur wijzigen, ventilatie stoppen, een alarm onderdrukken of een verwarmingsfunctie activeren. De gevolgen gaan daarom verder dan verlies van gegevens of productiviteit: zij kunnen producten, onvervangbare monsters, patiëntenzorg, onderzoek en bedrijfscontinuïteit bedreigen.
Beheer op afstand maakt ondersteuning van deze systemen eenvoudiger. Technici kunnen storingen diagnosticeren, instellingen aanpassen en installaties op meerdere locaties onderhouden zonder te reizen. Maar dat gemak creëert ook een toegangsroute naar krachtige besturingsfuncties. Als een onbevoegde toegang krijgt tot een overkoepelende controller, kunnen gewone configuratiehulpmiddelen al voldoende zijn om het proces te verstoren. Dezelfde toegang die efficiënt onderhoud mogelijk maakt, kan zo een bron van fysiek risico worden.
De Europese koelincidenten illustreren dit risico: openbare berichtgeving beschrijft gecompromitteerde afstandscontrollers en wijzigingen in bedrijfsparameters. Autoriteiten adviseerden organisaties om directe blootstelling aan het internet op te heffen, de volledige configuratie en ontdooischema’s te controleren, firmware bij te werken, standaardinloggegevens te wijzigen en toegang op afstand uitsluitend via een beveiligde verbinding te herstellen. Het probleem blijft niet beperkt tot commerciële koeling; het raakt ook diensten die verantwoordelijk zijn voor biologisch materiaal dat van levensbelang is.
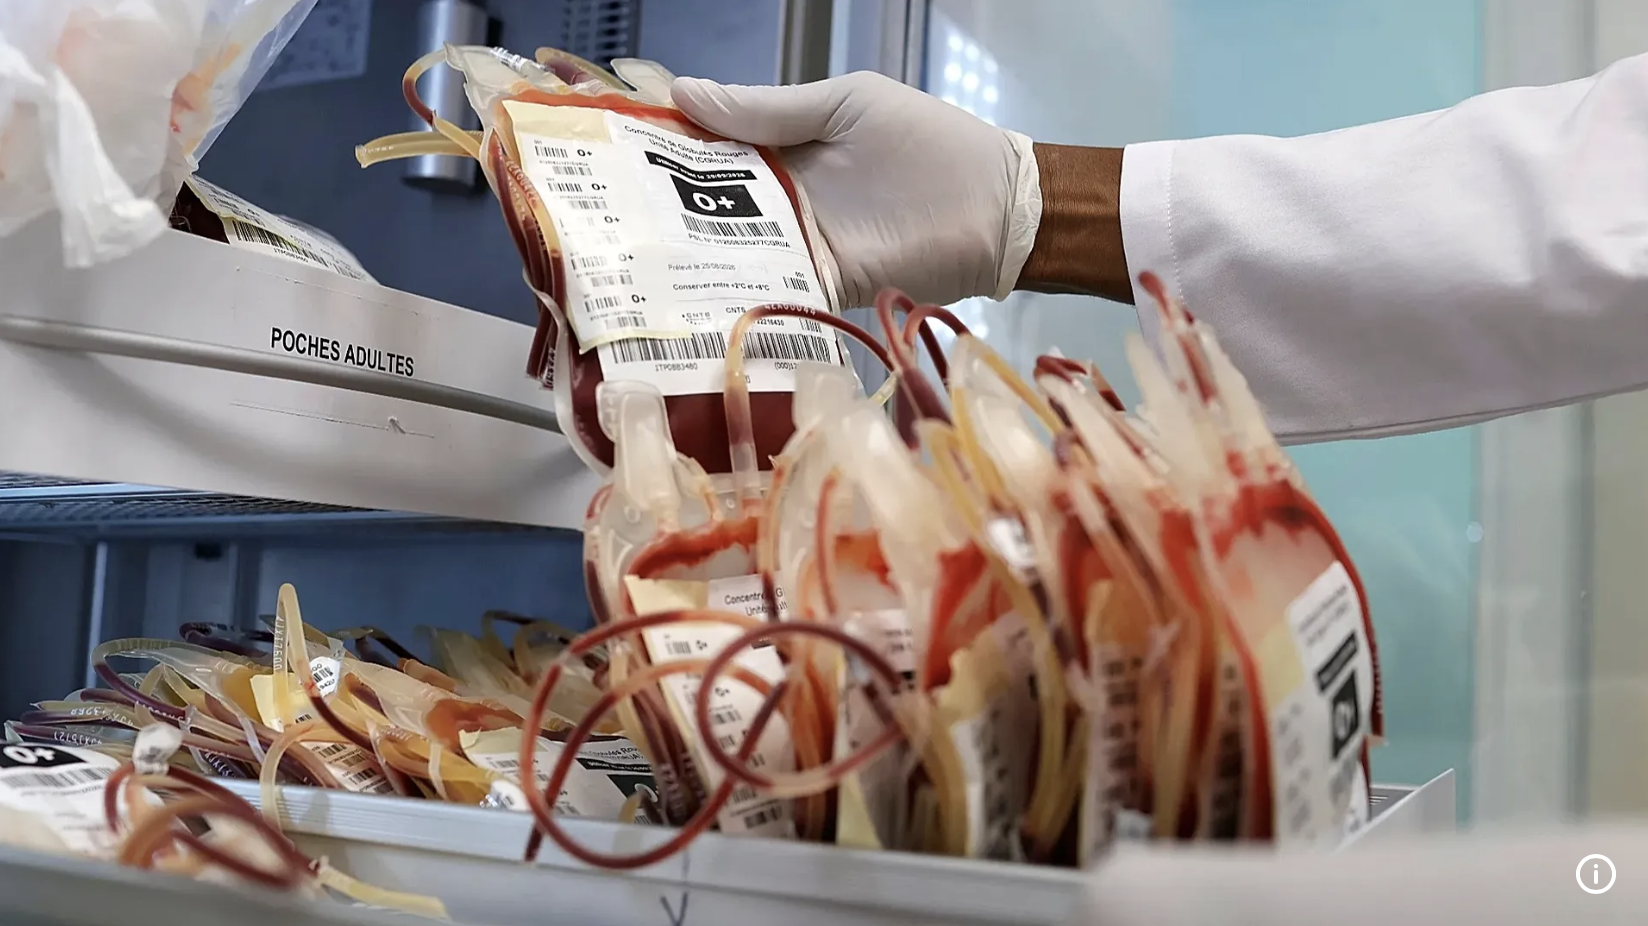
De gevolgen strekken zich ook uit tot bloedvoorzieningsorganisaties. In Frankrijk wijzigde een cybersecurityincident bij een leverancier van koelapparatuur de temperatuur- en ontdooi-instellingen van koelruimten voor de bloedvoorziening. Monitoring en alarmen maakten snel ingrijpen mogelijk: producten en monsters werden veiliggesteld of overgebracht, zonder gemelde verliezen van bloedproducten of gevolgen voor de gezondheid. In het Verenigd Koninkrijk ontstond de verstoring elders in de bloedvoorzieningsketen: een cyberaanval op pathologiediensten onderbrak transfusieonderzoek en kruisproeven, waardoor de afhankelijkheid van bloedgroep O toenam en een nationaal tekort mede werd veroorzaakt.
Deze incidenten laten verschillende faalroutes zien, niet één aanvalsmethode of een gemeenschappelijke dader, maar tonen waarom de bescherming van de bloedvoorziening aandacht vereist voor zowel fysieke opslagcondities als de digitale diensten die een veilige voorziening ondersteunen. De gedeelde les is dat zwakke plekken in verbonden apparatuur, leverancierstoegang of ondersteunende IT de bedrijfsvoering kunnen verstoren. Operationele weerbaarheid moet daarom de volledige keten omvatten, niet slechts één apparaat of leverancier.
Een risicogebaseerde aanpak moet ook verder kijken dan één verondersteld motief. Relevante scenario’s lopen uiteen van criminelen die door afpersing geld willen verdienen tot opzettelijke sabotage, met inbegrip van mogelijke terroristische motieven. Ook hybride oorlogsvoering is een scenario om rekening mee te houden: de Raad van de Europese Unie noemt cyberaanvallen en sabotage als onderdelen van hybride dreigingen. Deze mogelijkheden zijn geen bevestigde verklaringen voor de hier beschreven incidenten; toeschrijving vereist bewijs. Wat het motief ook is, de operationele vereiste blijft dezelfde: beveilig de toegang, detecteer schadelijke veranderingen en handhaaf gedurende de volledige levenscyclus van het systeem een effectieve respons.
Security by design moet ook tijdens het gebruik behouden blijven
Security by design wordt vaak besproken als een principe voor productontwikkeling. Bij besturingssystemen moet het veel verder reiken. Een veilig product kan alsnog onveilig worden wanneer het achter een open poort wordt geïnstalleerd, met gedeelde inloggegevens wordt geconfigureerd, op verouderde firmware blijft draaien of via een ongecontroleerde route voor toegang op afstand wordt onderhouden. Omgekeerd kan goede netwerksegmentatie niet blijvend compenseren voor een controller die geen beveiligingsupdates meer ontvangt.
De IEC 62443-reeks biedt een raamwerk voor de beveiliging van industriële automatiserings- en besturingssystemen. Zij verbindt productbeveiliging, systeemarchitectuur en operationele verantwoordelijkheden binnen een benadering van gedeelde verantwoordelijkheid. Fabrikanten, integratoren, dienstverleners en eigenaren moeten elk de risico’s binnen hun invloedssfeer beheersen en de bescherming gedurende de operationele levensduur van de installatie coördineren. Het raamwerk is dus niet simpelweg een reeks netwerkmaatregelen die na installatie worden toegepast: de principes moeten richting geven aan het productontwerp en onderdeel blijven van integratie, gebruik en doorlopende ondersteuning.
Voor besturingssystemen die aan het internet zijn blootgesteld of op afstand toegankelijk zijn, moet beveiliging beginnen in de productontwerpfase en niet pas na installatie worden toegevoegd. Het negeren van relevante IEC 62443-principes kan zwakke plekken verankeren in authenticatie, scheiding van bevoegdheden, invoerverwerking en updatemechanismen die met alleen netwerksegmentatie of zorgvuldig gebruik niet betrouwbaar zijn op te lossen. Het ontwerp moet voorzien in sterke authenticatie zonder standaard-, gedeelde of voorspelbare geheimen, configuratiebevoegdheden scheiden van uitsluitend uitlezende monitoring, belangrijke wijzigingen herleidbaar maken tot een individuele gebruiker en veilige firmware-updates bieden met transparante ondersteuningstermijnen. Deze beschermingsmaatregelen moeten tijdens integratie, inbedrijfstelling en doorlopend gebruik behouden blijven. Het toepassen van IEC 62443-principes garandeert echter geen foutloos product. Beheer op afstand moet gebruikmaken van beveiligde toegangsroutes in plaats van directe blootstelling aan het openbare internet, waarbij resterende risico’s worden vastgelegd en beoordeeld.
Zones en conduits: vertrouwensgrenzen beheersen
IEC 62443 groepeert bedrijfsmiddelen met gemeenschappelijke beveiligingseisen in zones, verbonden via gecontroleerde conduits. Een illustratieve architectuur onderscheidt een sensorzone voor meting en gegevensverwerving, een besturingssysteemzone voor controllers en actuatoren, en een operationele-systeemzone voor toezichthoudende applicaties en bedieningsinterfaces. Kantoor-IT en externe onderhoudstoegang kunnen afzonderlijke zones innemen. Conduits bepalen welke bronnen, bestemmingen, protocollen en communicatierichtingen zijn toegestaan, afgedwongen via gateways, firewalls of andere grensbeveiligingen. Meet-, toezicht- en onderhoudsverbindingen mogen geen onbeperkte besturingstoegang bieden. Alleen diagrammen en VLAN-labels bieden geen bescherming: grenzen moeten het verkeer daadwerkelijk beperken. Segmentatie beperkt blootstelling en de verspreiding van een compromittering, maar herstelt geen kwetsbare controllers en waarborgt evenmin de onafhankelijkheid van monitoring. Zie Beveiligingsaspecten van zones en conduits in IEC 62443.
Omzeiling van authenticatie en onveilige invoerverwerking zijn productbeveiligingsfouten
De koelincidenten tonen de fysieke gevolgen van onbevoegde besturing. Afzonderlijk kwetsbaarheidsonderzoek heeft omzeiling van authenticatie en commando-injectie gedocumenteerd: productbeveiligingsfouten in getroffen versies, niet uitsluitend implementatiefouten. Het omzeilen van authenticatie ondermijnt identiteitscontroles; het toestaan dat onvertrouwde invoer uitvoerbare commando’s wordt, legt onveilige invoerverwerking bloot. Fabrikanten moeten deze fouten verhelpen; segmentatie kan veilige producten niet vervangen. Bescherming vereist authenticatie en autorisatie op elke geprivilegieerde toegangsroute, serverzijdige invoervalidatie en scheiding van gegevens en uitvoerbare instructies. Het onderzoek toont ontwerp- of implementatiefouten aan, niet de misbruikroute bij elke aanval. Bijgewerkte firmware, gecontroleerde toegang en geverifieerde beschermingsmaatregelen blijven noodzakelijk.
Het onderzoek van Midnight Blue uit november 2026 onderstreept dit onderscheid: onderzoekers meldden meerdere kwetsbaarheden waarmee op afstand code zonder authenticatie kon worden uitgevoerd op koelcontrollers, ook met de nieuwste firmware die zij destijds onderzochten. Alleen firmware bijwerken of wachtwoorden wijzigen kan daarom niet aantonen dat een blootgesteld systeem veilig is. Directe blootstelling aan het internet moet worden opgeheven zonder op patches te wachten, terwijl beschikbare beveiligingsupdates onderdeel blijven van beheerst levenscyclusonderhoud. Deze bevindingen versterken het belang van veilig productontwerp en beperkte toegang op afstand.
Van raamwerk naar levenscyclus: bescherming in elke fase behouden
Deze principes maken een levenscyclusmodel noodzakelijk: veilig ontwerp legt de basis, maar de bescherming kan worden verzwakt door installatiekeuzes, configuratiewijzigingen, toegang op afstand of het einde van beveiligingsondersteuning. Een geloofwaardig beveiligingsmodel moet daarom productontwerp, integratie, verificatie en validatie, inbedrijfstelling, ondersteuning op afstand, patches en updates, incidentrespons en uiteindelijke vervanging omvatten. Dit zijn samenhangende verantwoordelijkheden, geen eenmalige checklist die bij de overdracht wordt afgevinkt. Gedurende de volledige levenscyclus moeten basisprincipes van IT-beveiliging, duidelijk eigenaarschap en gecoördineerde beschermingsmaatregelen in stand blijven, zodat de installatie veilig, ondersteunbaar en beheersbaar blijft wanneer omstandigheden veranderen.
Figuur 1: Beveiligingsmodel voor de levenscyclus van besturingssystemen.
Waar organisaties tekortschieten en wat dat kost
De fabrikant: functionaliteit zonder veilige levenscyclus
Een fabrikant creëert de eerste verdedigingslinie. De zwakte begint wanneer onderhoudbaarheid op afstand voorrang krijgt boven een veilige architectuur, of wanneer een apparaat ongedocumenteerde toegangsmechanismen, zwakke identiteitscontroles of onvoldoende logging bevat. Zij ontstaat ook wanneer updates moeilijk zijn uit te rollen of ondersteuning eindigt zonder een realistisch migratiepad.
De gevolgen kunnen veel verder reiken dan één apparaat. Een overkoepelende controller kan veel aangesloten bedrijfsmiddelen beheren en een gangbaar product wordt vaak op veel locaties op dezelfde manier ingezet. Eén zwakke plek kan zich daardoor herhalen. Fabrikanten moeten niet alleen worden beoordeeld op de vraag of de apparatuur vandaag functioneert, maar ook of zij gedurende de verwachte operationele levensduur veilig, bijwerkbaar en ondersteunbaar kan blijven.
Fabrikanten dragen een bijzondere verantwoordelijkheid omdat klanten mogelijk niet herkennen wanneer gemak, kostenbesparing of zwakke standaardinstellingen beveiligingsconcessies verhullen. Een gebrek aan technische expertise bij de klant mag geen excuus worden voor onveilig ontwerp of onduidelijke toezeggingen over ondersteuning. De EU Cyber Resilience Act (CRA), Verordening (EU) 2024/2847, legt verantwoordelijkheid bij fabrikanten van producten die binnen het toepassingsgebied vallen voor risicobeoordeling, security by design en by default, duidelijke gebruikersinstructies, een aangegeven ondersteuningsperiode en het afhandelen van kwetsbaarheden gedurende die periode. Dit versterkt het principe dat klanten verborgen zwakke plekken niet eerst zelf zouden moeten ontdekken voordat fabrikanten ze aanpakken. De belangrijkste CRA-verplichtingen gelden vanaf 11 december 2027; de meldplichten gelden sinds 11 september 2026. De toepasselijkheid moet voor elk product worden gecontroleerd, inclusief relevante uitzonderingen; de CRA neemt de verantwoordelijkheid van de klant voor veilig gebruik niet weg.
De eigenaar: apparatuur behouden omdat zij nog werkt
Werkende apparatuur is niet noodzakelijk veilig. Een controller kan de temperatuur correct regelen terwijl zijn beveiligingsmodel verouderd is. Bij netwerkgekoppelde apparatuur die kritieke processen beïnvloedt, moet het einde van beveiligingsondersteuning leiden tot vervanging, isolatie of een formeel goedgekeurde kortdurende uitzondering met compenserende maatregelen.
‘Dit werkt bij mij al twintig jaar. Waarom zouden we een werkende oplossing veranderen?’ Dit illustratieve bezwaar verwart betrouwbaarheid in het verleden met bescherming in het heden. Apparatuur kan onveranderd blijven terwijl dreigingen zich snel ontwikkelen. Behoud moet afhangen van de vraag of connectiviteit, ondersteuning en beschermingsmaatregelen geschikt blijven voor het doel, onderbouwd met een gedocumenteerd risicobesluit, niet uitsluitend van de gebruiksduur.
De gevolgen van uitstel zijn niet alleen af te meten aan een afschrijving van voorraden. Winkelvoorraden zijn mogelijk vervangbaar, hoewel bedrijfsonderbreking en hiaten in de verzekeringsdekking blijven bestaan. Embryo’s van patiënten en unieke longitudinale biobankmonsters zijn mogelijk in het geheel niet vervangbaar. Verlies van bruikbare bloedcomponenten kan tijdige transfusiezorg onderbreken. Eigenaren moeten daarom onomkeerbaar verlies, verstoring van behandelingen en wetenschappelijke gevolgen beoordelen, niet alleen de boekwaarde of een mogelijke verzekeringsuitkering.
De integrator: onderhoud op afstand verandert in publieke blootstelling
Fabrikant en integrator kunnen één organisatie zijn of afzonderlijke bedrijven. In beide gevallen gelden beide verantwoordelijkheden: de beveiligingsmogelijkheden en -beperkingen van het product uitleggen en een veilige installatie opleveren. Afzonderlijke leveranciers voegen koppelvlakken en overdrachtsmomenten toe; geen van beide partijen mag aannemen dat de ander eigenaar is van een onopgelost risico.
Publieke blootstelling, ruime portforwarding, hergebruikte wachtwoorden en ongedocumenteerde firewallregels kunnen een op zichzelf capabel product ondermijnen. Bij de overdracht moeten architectuur, gegevensstromen, bevoegdheden, beveiligingsconfiguratie, logging, verantwoordelijkheid voor patches en veilige isolatie worden vastgelegd, zodat voor de klant duidelijk is wie toegang heeft en wijzigingen mag uitvoeren.
Van ontwerp tot gebruik moeten de integrator en de interne of externe IT-dienstverlener van de klant afspraken maken over segmentatie, beveiligde toegang op afstand, individuele accounts, goedkeuringen, logging, monitoring en integratie met incidentrespons. Maatregelen moeten de cybersecurity beschermen zonder kritieke processen te verstoren.
Na de overdracht moeten klant, integrator en IT-dienstverlener documentatie en eigenaarschap bijhouden voor wijzigingen, updates, toegangsbeoordelingen, herstel en vervanging, zo nodig met betrokkenheid van de fabrikant. Wijzigingen in apparatuur of IT-omgeving moeten aanleiding zijn voor een gecoördineerde beoordeling om beveiliging en ondersteunbaarheid gedurende de levenscyclus te behouden.
De onderhoudspartij: toegang op afstand zonder evenredige verantwoordingsplicht
Onderhoud op afstand geeft geprivilegieerde toegang tot fysieke processen. Technici kennen de apparatuur mogelijk goed zonder cybersecurityspecialist te zijn. Dienstverleners moeten veilig werken daarom praktisch uitvoerbaar maken met toegankelijke hulpmiddelen, training en procedures. Maatregelen moeten installaties beschermen zonder regulier onderhoud of dringend ingrijpen te belemmeren.
Gebruik persoonsgebonden accounts, sterke authenticatie, vastgelegde bevoegdheden en gelogde sessies. Regel gecontroleerde noodtoegang in plaats van beschermingsmaatregelen te omzeilen. Zorg er samen met de IT-dienstverlener van de klant voor dat toegang efficiënt kan worden verleend, beoordeeld en ingetrokken, ook voor onderaannemers. Beveiliging moet het totale risico verminderen zonder grotere operationele problemen te veroorzaken.
Voor organisaties die onder NIS2 vallen, is onderhoudstoegang door derden ook een nalevingsvraagstuk in de toeleveringsketen. Artikel 21 vereist dat cybersecurityrisicobeheer aandacht besteedt aan directe leveranciers en dienstverleners, toegangsbeheersing en de doeltreffendheid van beschermingsmaatregelen. Ongecontroleerde of niet-gemonitorde toegang op afstand kan daarom een ernstige tekortkoming in de naleving vormen, afhankelijk van het toepasselijke nationale recht en het risicoprofiel van de organisatie. Onderhoudscontracten moeten goedkeuring van toegang, authenticatie, logging, monitoring, intrekking en incidentverantwoordelijkheden vastleggen, met bewijs dat deze maatregelen in de praktijk werken.
Interne IT, facilitaire dienst en management: gaten tussen verantwoordelijkheden
Verbonden koel-, HVAC- en laboratoriumapparatuur raakt IT, facilitaire zaken, kwaliteit en bedrijfsvoering. Medewerkers kunnen het doel ervan begrijpen, maar netwerkafhankelijkheden, risico’s van toegang op afstand of ondersteuningseisen over het hoofd zien. Wanneer IT vooral facilitaire apparatuur ziet, de facilitaire dienst op de leverancier vertrouwt en kwaliteit zich op naleving richt, kan een ketenverantwoordelijke voor essentiële beschermingsmaatregelen ontbreken.
Het management moet eigenaarschap toewijzen en interne teams en dienstverleners verbinden rond gezamenlijk risicobeheer, duidelijke afhankelijkheden en escalatieroutes. Het uitbesteden van taken draagt de eindverantwoordelijkheid voor operationele risico’s niet over. Niet-ondersteunde apparatuur, onduidelijk eigenaarschap en ongeverifieerde leverancierstoegang moeten zichtbaar blijven. Besluiten over vervanging en onafhankelijke monitoring moeten de gevolgen van uitval weerspiegelen, niet alleen de waarschijnlijkheid of aanschafprijs.
Figuur 2: Relaties en gedeelde verantwoordelijkheden tussen alle belanghebbenden.
Steeds complexere leverancierscoördinatie beheersen
Naarmate meer belanghebbenden betrokken raken, wordt het realiseren en onderhouden van een betrouwbare oplossing een grotere coördinatieopgave. Elke extra partij introduceert koppelvlakken, afhankelijkheden, goedkeuringsstappen en mogelijke hiaten in verantwoordelijkheden. Een wijziging die binnen één organisatie eenvoudig is, kan afstemming tussen meerdere leveranciers vereisen. Dit vertraagt de respons wanneer mondiale omstandigheden, dreigingen of operationele eisen snel veranderen. Een oplossing moet daarom niet alleen worden beoordeeld op de werking van afzonderlijke componenten, maar ook op de vraag of de volledige keten binnen de beschikbare tijd beheerd, getest en aangepast kan worden.
Organisaties moeten daarom overwegen onnodige overdrachten tussen leveranciers te verminderen en oplossingsaanbieders te selecteren die de keten voor operationele weerbaarheid van begin tot eind kunnen coördineren, in plaats van losse componenten te beheren. Binnen een duidelijk afgebakende contractuele reikwijdte moet de aanbieder verantwoordelijkheid nemen voor het leveren en onderhouden van de overeengekomen beschermingsmaatregelen voor ontwerp, integratie, monitoring, onderhoud, escalatie en herstel. De klant behoudt de eindverantwoordelijkheid voor risicoacceptatie, operationele besluiten en de menselijke respons. Het doel is minder hiaten tussen deze activiteiten, met duidelijke bevoegdheden om wijzigingen snel te coördineren.
Dit betekent niet dat essentiële belanghebbenden moeten worden uitgesloten of dat één leverancier alle risico’s wegneemt. Leveranciersconsolidatie en de onafhankelijkheid van monitoring hebben betrekking op verschillende vraagstukken: minder overdrachten kunnen de coördinatie vereenvoudigen, terwijl afzonderlijke meting, alarmbeoordeling en passend onafhankelijke stroom- en communicatievoorzieningen risico’s op gezamenlijke uitval verminderen. Elke geconsolideerde oplossing moet die onafhankelijkheid aantonen, transparante verantwoordelijkheden en toezicht door de klant behouden, en een geloofwaardig continuïteits- en exitplan bevatten. Het doel is een eenvoudiger inrichting met duidelijkere verantwoordingslijnen, die in de dagelijkse praktijk betrouwbaar blijft en zich kan aanpassen wanneer omstandigheden veranderen.
Waarom preventie alleen niet voldoende is
Goede cybersecurity verkleint de kans op compromittering, maar kan niet garanderen dat deze nooit zal optreden. Inloggegevens kunnen worden gestolen, een vertrouwde leverancier kan worden gehackt, een configuratiefout kan een systeem blootstellen en een bevoegde technicus kan een schadelijke wijziging aanbrengen. Nieuwe kwetsbaarheden kunnen bestaan voordat er een patch beschikbaar is. Zelfs een veilige update kan een onverwacht operationeel effect hebben.
Een weerbaar ontwerp houdt daarom gelijktijdig rekening met twee vragen. Hoe voorkomen we onbevoegde toegang? En hoe detecteren we het fysieke gevolg als toegang, configuratie of besturing toch misgaat? De eerste vraag hoort bij preventieve beveiliging. De tweede vereist een onafhankelijke bron van waarheid.
Een cruciaal onderscheid. Een alarm dat wordt gegenereerd door dezelfde controller die wordt gemanipuleerd, is geen volledig onafhankelijke beschermingslaag. Werkelijke onafhankelijkheid vereist afzonderlijke meting, afzonderlijke beoordeling en, waar passend, een afzonderlijke stroomvoorziening en communicatieroute.
Onafhankelijke monitoring als tweede bron van waarheid
De besturingsroute en de onafhankelijke monitoringroute naast elkaar.
Onafhankelijke monitoring biedt een tweede bron van waarheid door fysieke omstandigheden afzonderlijk van de primaire controller te meten en onafhankelijk beheerde alarmgrenzen toe te passen. Het eerder beschreven incident bij de Franse bloedvoorziening toont de praktische waarde van monitoring, alarmen en tijdig ingrijpen: producten en monsters werden veiliggesteld of overgebracht, zonder gemelde verliezen van bloedproducten of gevolgen voor de gezondheid. Deze uitkomst onderstreept het belang van effectieve waarschuwing, maar bewijst op zichzelf niet de architectonische onafhankelijkheid of redundantie van de betrokken systemen.
Effectieve monitoring moet beschikbaar blijven tijdens de storingen die zij geacht wordt zichtbaar te maken. Een groter incident kan de internetverbinding of stroomvoorziening van een volledige locatie onderbreken en daarmee mogelijk zowel primaire apparatuur als de bijbehorende alarmketen uitschakelen. Onafhankelijke monitoring heeft daarom voldoende redundantie nodig om waarschuwing en escalatie in stand te houden onder de verstoringsscenario’s uit de risicobeoordeling. Zij kan de oorspronkelijke aanval niet voorkomen en de bestuurde apparatuur niet zelfstandig in bedrijf houden.
Redundantie moet de volledige monitoringketen omvatten en mag niet ophouden bij een extra sensor of dashboard. De risicobeoordeling moet bepalen tegen welke verstoringsscenario’s en welke duur van autonome werking het systeem bestand moet zijn, samen met de voorzieningen die nodig zijn om meting, lokale alarmbeoordeling, gegevensbuffering, noodstroom en alternatieve communicatieroutes in stand te houden. Een terugvalroute mag niet afhankelijk zijn van dezelfde verbinding of stroombron waarvan zij de uitval moet opvangen. Dezelfde principes voor veilig ontwerp en levenscyclusbeheer zijn van toepassing: het systeem moet worden onderhouden, bijgewerkt en getest, inclusief oefeningen waarbij de normale stroom- en internetvoorziening worden weggenomen en wordt gecontroleerd of alarmen nog steeds mensen bereiken die kunnen ingrijpen. Deze maatregelen scheppen een mogelijkheid om tijdig in te grijpen; zij garanderen niet dat elk verlies kan worden voorkomen. Alle resterende beperkingen moeten binnen het risicobeoordelingsproces worden begrepen en geaccepteerd.
Een volwassener bedrijfsmodel
Een volwassen bedrijfsmodel begint met een grondige risico-inventarisatie en -beoordeling, niet met de aanschaf van apparatuur of de aanname dat bestaande beschermingsmaatregelen voldoende zijn. Organisaties moeten kritieke processen, waardevolle monsters en verbonden bedrijfsmiddelen identificeren, hun afhankelijkheden van stroom, netwerken en leveranciers begrijpen en de gevolgen van uitval of compromittering beoordelen. De beoordeling moet vaststellen welke risico’s actie vereisen, wie daarvoor verantwoordelijk is en welk niveau van bescherming en continuïteit nodig is. Zij vormt de basis voor besluiten over veilige connectiviteit, vervanging van apparatuur, onafhankelijke monitoring en menselijke respons.
Wanneer klanten niet over de expertise, middelen of capaciteit beschikken om dit zelf uit te voeren, moeten zij een gespecialiseerd bedrijf inschakelen met aantoonbare ervaring en het vermogen hun operationele omgeving te beoordelen. Selectie moet berusten op relevante ervaring, een duidelijke beoordelingsmethode en bewijs dat de aanbieder bevindingen kan vertalen naar praktische, beheersbare beschermingsmaatregelen, niet alleen producten kan aanbevelen. De operationele, IT-, facilitaire en kwaliteitsteams van de klant moeten bij dit werk worden betrokken, zodat technische afhankelijkheden en de gevolgen van verlies van monsters of dienstverlening in samenhang worden begrepen. Externe ondersteuning versterkt de beoordeling; zij draagt de eindverantwoordelijkheid van de klant voor het accepteren en beheersen van risico’s niet over.
Het resultaat moet een gedocumenteerd, geprioriteerd actieplan zijn met duidelijke verantwoordelijkheden, overeengekomen termijnen en financiering. Het moet ingaan op blootstelling via toegang op afstand, toegangsbeheersing, firmware- en ondersteuningsstatus, leveranciersverantwoordelijkheden, veilige isolatie en de onafhankelijkheid en redundantie van monitoring. Vervolgens moeten beschermingsmaatregelen worden geverifieerd met tests van de alarmketen, responsoefeningen buiten werktijd en controles bij uitval van de normale stroomvoorziening of verbinding. Risico-inventarisatie en -beoordeling zijn doorlopende verantwoordelijkheden: zij moeten opnieuw worden bekeken wanneer apparatuur, leveranciers, connectiviteit of dreigingen veranderen, zodat de bescherming blijft aansluiten bij de feitelijke operationele omgeving.
XiltriX Resilience ondersteunt operationele weerbaarheid
XiltriX Resilience is ontworpen om operationele weerbaarheid te ondersteunen door een onafhankelijke monitoringlaag te bieden in bedrijfskritische omgevingen. De bijdrage combineert fysieke infrastructuur, intelligente monitoring en doorlopende dienstverlening, in plaats van te vertrouwen op één sensor of softwarefunctie. Deze elementen ondersteunen detectie, meldingen en opvolging, maar effectieve bescherming hangt ook af van de beveiliging van de primaire systemen van de klant, diens risicobesluiten en de menselijke respons. Technologie en dienstverlening moeten binnen dat model van gedeelde verantwoordelijkheid samenwerken.
Infrastructure: de fysieke werkelijkheid meten
Specifieke monitoringstations en sensoren creëren een meetroute buiten de primaire besturingslogica. Afhankelijk van de toepassing kan deze temperatuur, luchtvochtigheid, drukverschil, zuurstof, kooldioxide, deurstatus, alarmcontacten van apparatuur, voedingsstatus en de toestand van communicatieverbindingen omvatten. Lokale buffering en werking met batterijondersteuning helpen bewijsmateriaal en inzicht tijdens verstoringen te behouden.
Van fysieke meting naar de juiste respons
-
Onafhankelijke sensoren meten incubatoren, koelkasten, ruimtecondities en cryogene opslag.
-
Specifieke monitoringstations bieden lokale buffering en werking met batterijondersteuning.
-
Veilige cloudhosting ondersteunt monitoringgegevens, SSO en de REST API.
-
Omgevingsafwijkingen volgen de door de klant vastgestelde meldings- en escalatieroute naar het team op de locatie.
-
Storingen in het monitoringsysteem gaan naar de technische ondersteuning van XiltriX; 24/7 technische ondersteuning op afstand valt onder Intelligence.
Figuur 3: De mogelijkheden van XiltriX Resilience (www.xiltrix.com)
Intelligence: detecteren en communiceren wat ertoe doet
De softwarelaag beoordeelt metingen continu, beheert alarmdrempels en biedt dashboards, meldingen, escalatie, incidentrapportage en bewijs voor naleving. Diagnostiek op afstand en bewaking van de systeemstatus helpen om omgevingsafwijkingen te onderscheiden van problemen met sensoren, stroom of communicatie. Het monitoringplatform vereist ook veilige cloudhosting en doorlopend beheer van de softwarelevenscyclus, zodat het ondersteund blijft in plaats van een onbeheerd verouderd systeem te worden.
Intelligence omvat software- en OTA-firmware-updates en 24/7 technische ondersteuning op afstand voor het monitoringsysteem zelf. De klant blijft verantwoordelijk voor het reageren op omgevings- en apparatuuralarmen.
Care: dienstverlening op locatie
Care omvat dienstverlening op locatie: installatie door partners met ondersteuning van XiltriX, inbedrijfstelling, validatie, training, kalibratie en onderhoud.
Verantwoordelijkheden voor technische monitoring en respons door de klant
XiltriX is verantwoordelijk voor de technische monitoringketen, waaronder meting, gegevensregistratie, alarmgeneratie en technische aflevering van meldingen binnen de overeengekomen dienstverlening. Storingen in het monitoringsysteem worden afgehandeld door de technische ondersteuning van XiltriX. De locatie of het klantteam blijft verantwoordelijk voor het actueel houden van alarmcontacten en responsprocedures, het bevestigen van operationele alarmen, het beoordelen van hun betekenis en tijdig handelen om monsters, producten en patiënten te beschermen. Technische alarmaflevering is geen operationeel ingrijpen.
Voegt XiltriX-monitoring een aanvalsoppervlak toe?
De monitoringconfiguratie van XiltriX scheidt meting van besturing: Pt1000-sensoren, 4–20 mA-signalen en potentiaalvrije contactingangen registreren fysieke omstandigheden onafhankelijk van de primaire regelkring of PLC’s. In deze configuratie is geen actuatorverbinding of schrijvende verbinding naar een controller aanwezig: monitoring kan niet op afstand instelwaarden wijzigen of koelmachines uitschakelen. Versleutelde telemetrie gebruikt verbindingen die van binnenuit worden opgezet, zonder dat inkomende firewallpoorten of portforwarding nodig zijn. Implementatieopties omvatten een specifiek, door een firewall gesegmenteerd VLAN of een uitsluitend mobiele communicatieroute die gescheiden is van het locatienetwerk, geen echte air gap. Het IT-/beveiligingsteam van de klant moet vóór goedkeuring de geïmplementeerde gegevensstromen, isolatie en afwezigheid van besturingsroutes verifiëren.
Belangrijke opmerking. XiltriX Resilience mag niet worden gepositioneerd als reden om een onveilige primaire controller te tolereren. Het is een laag binnen defence in depth die de afhankelijkheid van één controller, netwerk, communicatieroute of serviceorganisatie vermindert. De primaire omgeving moet nog steeds worden beveiligd, gepatcht en vervangen wanneer ondersteuning eindigt.
Vragen die leidinggevenden moeten kunnen beantwoorden
Leidinggevenden in elk bedrijf moeten ‘In Control’ zijn, niet alleen in farmaceutische of andere sterk gereguleerde omgevingen. Dit betekent inzicht hebben in de risico’s die de organisatie loopt, de gevolgen van falen en de beschikbare mogelijkheden om die risico’s te beperken. Het vereist niet dat zij elk technisch detail beheersen of alle risico’s uitsluiten. Het vereist een actuele risico-inventarisatie en -beoordeling, onderbouwde besluiten over proportionele beschermingsmaatregelen, duidelijk eigenaarschap en bewijs dat die maatregelen werken. Leidinggevenden moeten het risico begrijpen dat na maatregelen resteert en expliciet besluiten of dit aanvaardbaar is.
De Weten, Bereiken, Handelen-test: als de primaire controller zou worden gecompromitteerd en de normale stroom- en internetvoorziening uitvielen, zouden we dan onafhankelijk de fysieke omstandigheden kennen, een verantwoordelijke persoon bereiken en ingrijpen voordat onomkeerbare schade ontstaat? Om te slagen zijn aantoonbaar onafhankelijke meting, een geteste meldings- en escalatieroute en een respons onder verantwoordelijkheid van de locatie nodig, voltooid binnen de beschikbare tijd van het beoordeelde scenario. Alleen een alarm is niet voldoende.
De essentiële vragen zijn praktisch: welke verbonden systemen kunnen een kritisch proces beïnvloeden en wie heeft er toegang toe? Wordt toegang individueel geauthenticeerd en gelogd? Wanneer eindigt beveiligingsondersteuning en kan apparatuur veilig worden geïsoleerd? Wat gebeurt er als stroom, internetverbinding of een belangrijke leverancier uitvalt? Welke preventieve maatregelen, onafhankelijke monitoring en herstelvoorzieningen kunnen de gevolgen beperken, en wie reageert buiten normale werktijden? Waar expertise ontbreekt, moeten leidinggevenden deskundige ondersteuning inschakelen en tegelijk toezicht houden. ‘In Control’ zijn betekent deze keuzes kunnen uitleggen en de uitvoering kunnen aantonen, niet eenvoudig aannemen dat IT of een leverancier alles heeft geregeld.
Europese cybersecuritywetgeving geeft deze verantwoordingsplicht een juridische dimensie voor organisaties die binnen het toepassingsgebied vallen. Artikel 20 van de NIS2-richtlijn verplicht lidstaten ervoor te zorgen dat bestuursorganen van essentiële en belangrijke entiteiten maatregelen voor cybersecurityrisicobeheer goedkeuren, toezicht houden op de uitvoering en aansprakelijk kunnen worden gesteld voor inbreuken op die verplichtingen. Het verplicht leden van bestuursorganen ook om opleiding te volgen. De toepasselijke verplichtingen en aansprakelijkheidsmechanismen moeten worden getoetst aan de nationale omzettingswetgeving; deze bepalingen gelden niet zonder onderscheid voor elk bedrijf.
De Cyber Resilience Act (CRA), Verordening (EU) 2024/2847, legt daarnaast productbeveiligingsverantwoordelijkheden vast voor fabrikanten van producten die binnen het toepassingsgebied vallen, waaronder risicobeoordeling, security by design en by default, en de afhandeling van kwetsbaarheden gedurende de aangegeven ondersteuningsperiode. Leidinggevenden van betrokken fabrikanten moeten ervoor zorgen dat hun organisaties deze verantwoordelijkheden kunnen nakomen; de CRA mag niet worden voorgesteld als een regeling met hetzelfde persoonlijke bestuurdersaansprakelijkheidsregime als NIS2. De CRA-meldplichten gelden sinds 11 september 2026; de belangrijkste verplichtingen gelden vanaf 11 december 2027. Leidinggevenden moeten vaststellen welke regels op hun organisatie en producten van toepassing zijn en waar nodig juridisch advies inwinnen. Het bredere managementprincipe blijft relevant voor elk bedrijf: begrijp de blootstelling, kies passende risicobeperkende maatregelen en bewaar bewijs van onderbouwd toezicht.
Conclusie
De Europese koelincidenten zijn geen reden om op de volgende waarschuwing te wachten. Zij leggen bloot hoe toegang op afstand, verouderde apparatuur en versnipperde verantwoordelijkheid een digitale compromittering kunnen omzetten in fysiek verlies. De druk zal naar verwachting toenemen: het Britse National Cyber Security Centre beoordeelt dat AI vrijwel zeker de frequentie en intensiteit van cyberdreigingen zal verhogen, waarbij het zeer waarschijnlijk is dat het aantal en de impact van indringingen tot en met 2027 toenemen. Naarmate aanvallen frequenter en efficiënter worden, lopen organisaties het risico dat de benodigde inspanningen voor detectie, coördinatie en respons hen boven het hoofd groeien. Vertrouwen op mensen die na elk incident sneller reageren, is geen duurzame beschermingsstrategie.
Leidinggevenden in elk bedrijf moeten ‘In Control’ zijn voordat een incident begint. Dat vereist een actuele risico-inventarisatie en -beoordeling, expliciete besluiten over risicobeperking en duidelijke verantwoordingslijnen tussen fabrikanten, integratoren, onderhoudspartijen en interne teams. Niet-ondersteunde apparatuur en onduidelijke leverancierstoegang moeten worden aangepakt, niet worden getolereerd omdat de installatie nog werkt. Waar expertise ontbreekt, moet deskundige ondersteuning worden ingeschakeld. Het doel is blootstelling te verminderen en vermijdbare vertragingen weg te nemen voordat een schadelijke verandering een dringende respons vereist.
Zelfs dan mag preventie niet de enige barrière zijn tussen een aanval en onomkeerbare schade. Onafhankelijke monitoring is de laatste verdedigingslinie voor het detecteren van schadelijke fysieke veranderingen, en de stroom-, communicatie- en escalatievoorzieningen ervan moeten bestand zijn tegen de storingen die zij geacht wordt zichtbaar te maken. Die voorzieningen moeten samen met de mensen die bevoegd zijn om in te grijpen worden getest. Naarmate de aanvalsdruk toeneemt, kost elke vermijdbare vertraging tijd die nodig kan zijn om monsters, producten en diensten te beschermen. Weerbaarheid moet vooraf worden ontworpen, onderhouden en geoefend: zodra fysieke schade ontstaat, is er mogelijk geen tweede kans.
Tot slot. Operationele weerbaarheid begint met de aanname dat storingen zullen optreden. Zij vereist geteste risicobeperkende maatregelen die zijn ontworpen om problemen vroeg te detecteren, de gevolgen te beperken en tijd te creëren om in te grijpen voordat onomkeerbare schade ontstaat. Die beschermingsmaatregelen moeten aanpasbaar blijven wanneer mondiale omstandigheden, dreigingen en operationele eisen snel veranderen.
Referenties
-
Wikipedia, Operationele technologie (achtergronddefinitie). Geraadpleegd op 5 november 2026.
-
CERT-FR, CERTFR-2026-ALE-012, Beveiligingsincident gericht op afstandscontrollers van koelinstallaties, 12 oktober 2026, bijgewerkt op 16 oktober 2026. Geraadpleegd op 18 november 2026.
-
EN IEC 62443-reeks: Deel 4-1, Eisen aan de levenscyclus voor veilige productontwikkeling; Deel 2-4, Eisen aan beveiligingsprogramma’s van IACS-dienstverleners; en Deel 3-3, Systeembeveiligingseisen en beveiligingsniveaus. Ondersteunend overzicht: NEN, IEC 62443: Industriële cybersecurity. Geraadpleegd op 5 november 2026.
-
Richtlijn (EU) 2022/2555 (NIS2), Artikelen 20–21: governance en maatregelen voor cybersecurityrisicobeheer. Geraadpleegd op 5 november 2026.
-
Europese Commissie, Cyber Resilience Act – Fabrikanten en Cyber Resilience Act: tijdschema voor toepassing. Geraadpleegd op 5 november 2026.
-
Brits National Cyber Security Centre, Impact van AI op de cyberdreiging van nu tot 2027, 2025. Geraadpleegd op 5 november 2026.
-
Établissement français du sang (EFS), verklaring over het cybersecurityincident bij een leverancier van koelapparatuur, november 2026. Geraadpleegd op 5 november 2026.
-
NHS England – London, Laatste persverklaring over de cyberaanval op Synnovis. Geraadpleegd op 5 november 2026.
-
Raad van de Europese Unie, Hybride dreigingen. Geraadpleegd op 5 november 2026.
-
NIS2 Info, NIS2-richtlijn: Artikel 20 – Governance (secundaire weergave van de bepaling; de officiële richtlijn staat hierboven vermeld). Geraadpleegd op 5 november 2026.
-
NU.nl, bericht over cyberaanvallen op koelinstallaties en verzekeringsdekking voor bedorven voorraad (gelinkt in de managementsamenvatting).
-
XiltriX International, bedrijfswebsite (gelinkt in Figuur 3).
-
Jaatun et al., Beveiligingsaspecten van zones en conduits in IEC 62443, Journal of Cybersecurity and Privacy, 2026, 6(2), 52. Geraadpleegd op 18 november 2026.
-
Claroty Team82, Bevries de controller, ontdooi het voedsel: kwetsbaarheden in Danfoss-koelcontrollers blootgelegd, 9 augustus 2026. Geraadpleegd op 18 november 2026.
-
Claroty, Aan het internet blootgestelde koelcontrollers op meerdere locaties vinden en beveiligen, 4 november 2026. Geraadpleegd op 18 november 2026.
-
Midnight Blue, onderzoek naar meerdere kwetsbaarheden voor uitvoering van code op afstand zonder voorafgaande authenticatie in koelcontrollers, november 2026. Geraadpleegd op 18 november 2026.
-
Centrum voor Cybersecurity België, advies over zes nieuw gemelde kwetsbaarheden in koelcontrollers en onmiddellijke beperking van blootstelling, 12 november 2026. Geraadpleegd op 18 november 2026.