Am Karolinska Institutet, im Cleveland Fertility Center und im Pacific Fertility Center überwachten hochmoderne Laboratorien Umgebungen, die zum Schutz von unersetzlichem biologischem Material konzipiert waren. Dennoch gingen Tausende von Proben verloren. Nicht, weil niemand überwachte, sondern weil die Überwachung allein nicht ausreichte.
Diese Vorfälle decken eine grundlegende Schwäche in der Art und Weise auf, wie kritische Laborumgebungen oft geschützt werden. Sensoren messen. Alarme warnen. Dashboards zeigen an. Aber wenn etwas schiefgeht, garantiert nichts davon, dass die richtige Person rechtzeitig davon erfährt, es versteht, die Verantwortung übernimmt und handelt.
Der Unterschied zwischen Überwachung und betrieblicher Sicherheit lässt sich daran messen, was als Nächstes geschieht.
Karolinska Institutet: Der Ausfall begann, bevor sich die Temperatur änderte
Im Dezember 2023 erlitt das Karolinska Institutet einen katastrophalen Ausfall der kryogenen Lagerinfrastruktur in seiner Neo-Einrichtung in Stockholm. Ungefähr 47.100 biologische Proben, die über Jahrzehnte angesammelt worden waren, gingen letztendlich verloren.
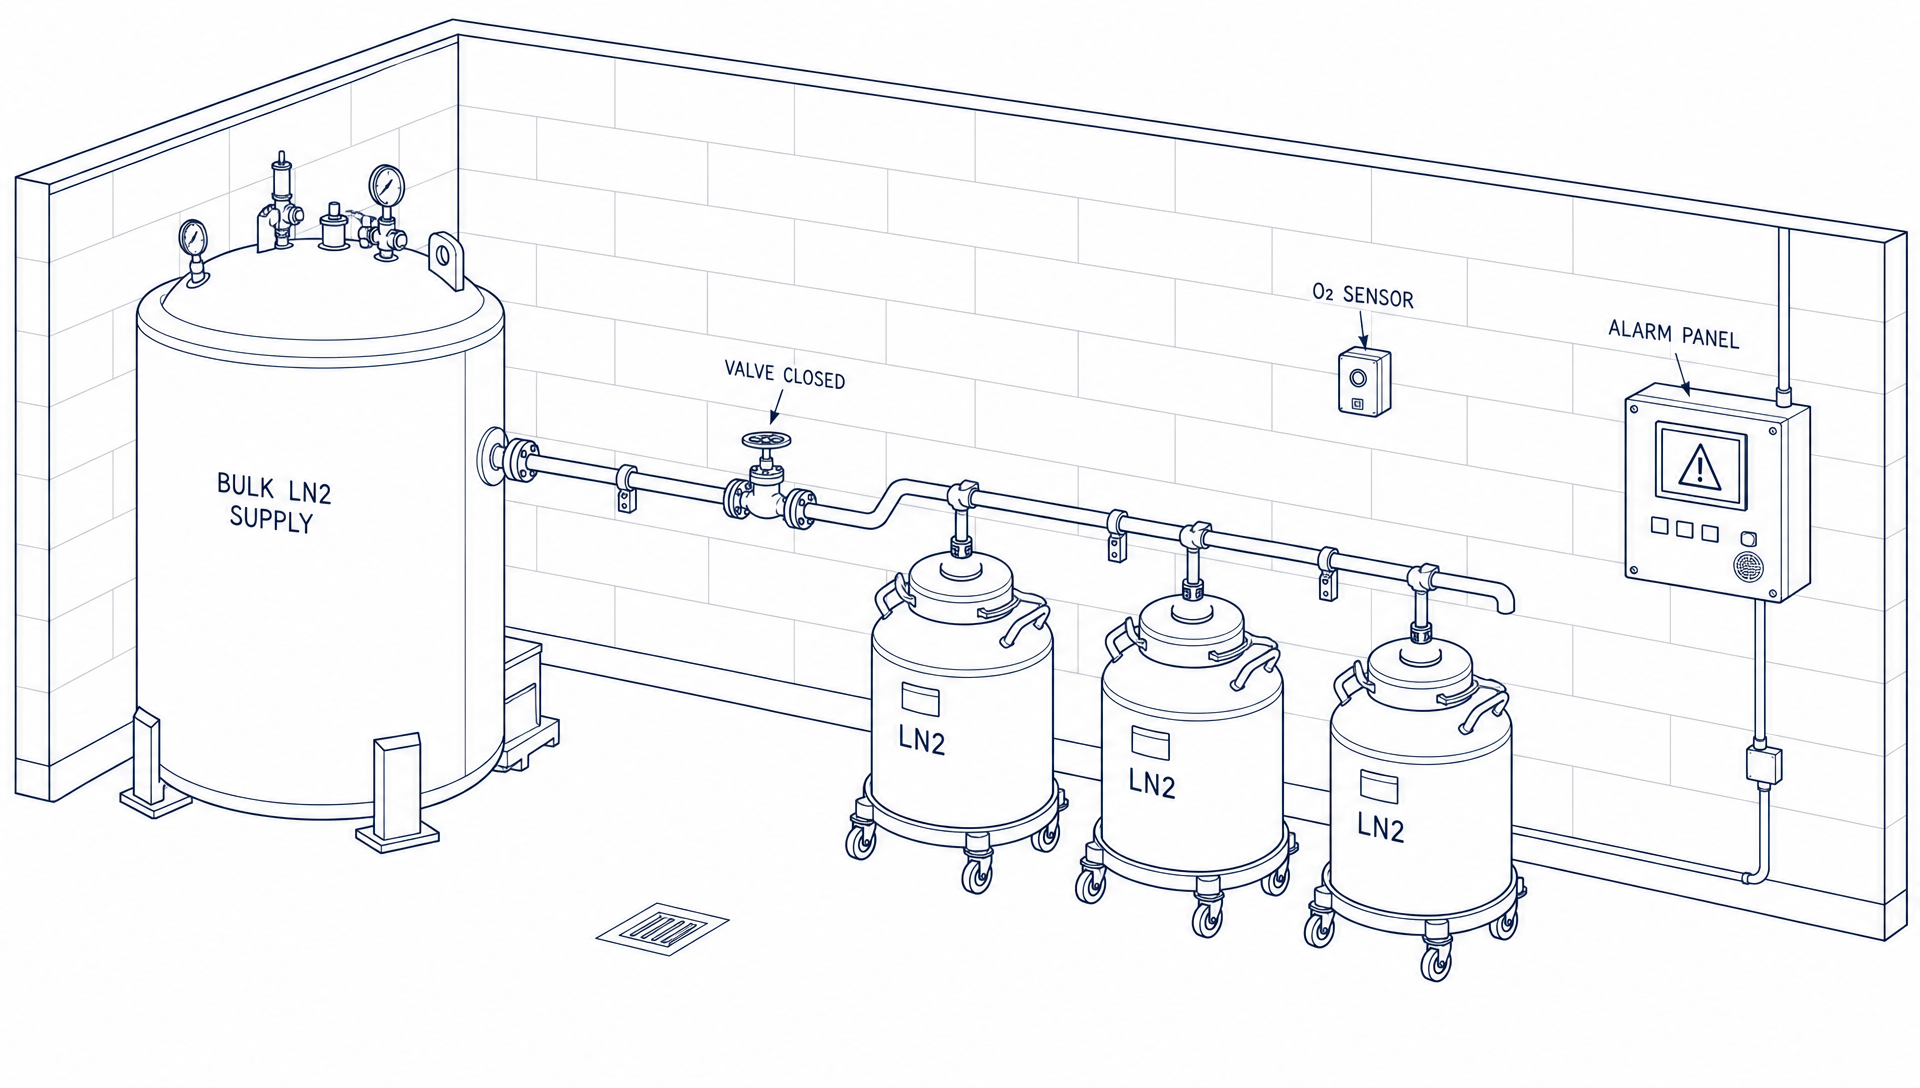
Die Untersuchung ist aufschlussreich, eben weil der Vorfall nicht damit begann, dass ein Gefrierschrank plötzlich zu warm wurde. Während geplanter Wartungsarbeiten wurde ein Alarm für den Sauerstoffgehalt ausgelöst. Dadurch wurde das Ventil am zentralen Flüssigstickstofftank geschlossen und die Versorgung der kryogenen Lagertanks unterbrochen. Die Versorgung wurde nie wiederhergestellt.
Die einzelnen Tanks verfügten über genügend Reserven, um eine Zeit lang weiterzubetreiben, sodass ihre Flüssigstickstoffstände allmählich sanken. Erst später verschlechterten sich die Bedingungen in den Tanks. Die Abfolge war im Wesentlichen:
Wartungsereignis → LN₂-Versorgung unterbrochen → Reserve aufgebraucht → Bedingungen verschlechtert → Alarme ausgelöst → Eingriff fehlgeschlagen → Probenverlust.
Die nachträgliche Analyse ergab eine Kette von technischen und organisatorischen Mängeln anstelle eines einzelnen, isolierten Fehlers. Die Zuständigkeiten waren unklar. Kommunikation und Informationsaustausch waren unzureichend. Die Alarmtests waren ungenügend. Die Kontaktdaten waren veraltet. Frühere Vorfälle waren nicht ordnungsgemäß dokumentiert worden, und die Organisation verfügte über die Weihnachtsfeiertage über keine effektive 24/7-Reaktionsfähigkeit.
Die Alarme waren nicht einfach nicht vorhanden. Signale wurden erzeugt. Nachrichten wurden gesendet. Was der Organisation fehlte, war ein zuverlässiger Mechanismus, um diese Signale in eine verifizierte Reaktion umzuwandeln.
Die Lehre daraus ist tiefgreifend: Ein Alarm ist kein Kontrollsystem. Er ist ein Glied in einem Kontrollsystem.
Cleveland Fertility Center: Als das Sicherheitsnetz abgeschaltet wurde
Im März 2018 ereignete sich im University Hospitals Fertility Center in Cleveland ein Vorfall bei der kryogenen Lagerung, von dem mehr als 4.000 Eizellen und Embryonen von rund 950 Patienten betroffen waren.
Der Lagertank verfügte über einen Fernalarm, der das Personal bei einer Verschlechterung der Bedingungen benachrichtigen sollte. Der Alarm war abgeschaltet worden. Das Krankenhaus konnte nicht feststellen, wann oder von wem er deaktiviert worden war. Der Tank hatte auch Probleme mit seinem Flüssigstickstoff-Nachfüllsystem. Als sich die Lagerbedingungen verschlechterten, bot die erwartete Fernwarnung einfach nicht den Schutz, für den sie konzipiert war.
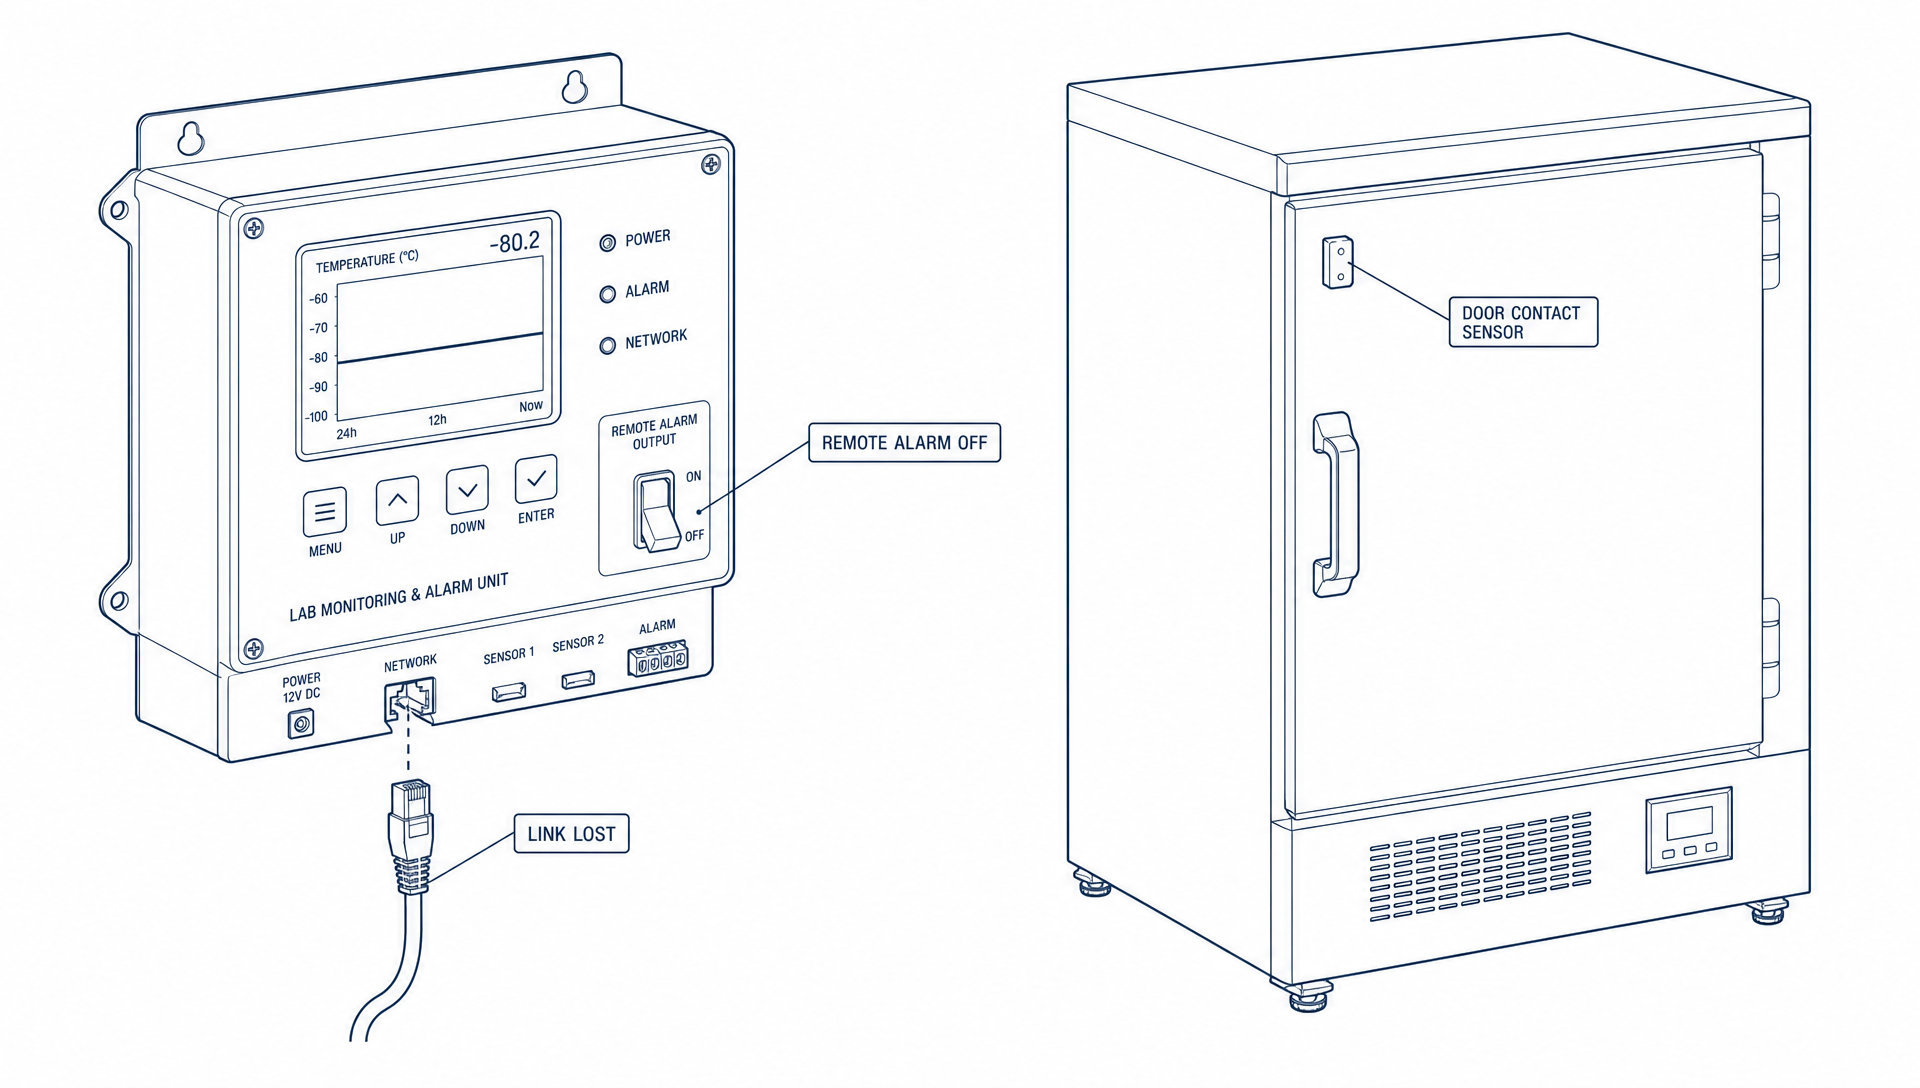
Dies ist eine andere Schwachstelle als beim Karolinska-Institut. Die Frage war nicht, ob ein Alarm existierte, sondern ob die Organisation wusste, dass der Alarm selbst verfügbar, angeschlossen und betriebsbereit war.
Ein Überwachungssystem, das unbemerkt ausfallen kann, schafft etwas Gefährlicheres als gar keine Überwachung: falsches Vertrauen.
Pacific Fertility Center: Der Mensch wurde zur letzten Verteidigungslinie
Am selben Tag wie der Vorfall in Cleveland erlitt das Pacific Fertility Center in San Francisco einen Ausfall bei der kryogenen Lagerung in einem Tank, der ungefähr 2.500 Embryonen und 1.500 Eizellen enthielt.
Dieser Fall lehrt die gegenteilige Lektion. Ein Embryologe entdeckte bei einem physischen Kontrollgang, dass der Flüssigstickstoffstand in einem Tank gefährlich tief gesunken war. Das Team reagierte sofort und transferierte das Material in einen anderen Tank. Die menschliche Inspektion wurde zur entscheidenden Sicherheitsbarriere.
Die nachfolgenden Untersuchungen befassten sich mit dem Ausfall des Tanks sowie der Zuverlässigkeit und Redundanz seiner Überwachungs- und Alarmsysteme. Detaillierte Berichte hoben ein Problem hervor, mit dem jede Fertilitätsklinik und jede kryogene Einrichtung konfrontiert ist: Keine einzelne Schutzmaßnahme sollte als unfehlbar angesehen werden.
Die Lehre daraus ist nicht, dass die menschliche Inspektion unnötig ist. Sondern, dass die menschliche Inspektion nicht die letzte Verteidigung gegen einen Ausfall sein sollte, den ein unabhängiges Überwachungssystem erkennen müsste.
Drei Vorfälle, drei Ausfallarten, ein Problem
Technisch gesehen waren die drei Fälle sehr unterschiedlich.
- Am Karolinska-Institut wurde die Versorgung der kontrollierten Umgebung unterbrochen, und die Organisation schaffte es nicht, sie rechtzeitig wiederherzustellen.
- In Cleveland war das Fernalarmsystem selbst nicht verfügbar.
- Im Pacific Fertility Center entdeckte menschliche Beobachtung einen sich verschlechternden Zustand, den der automatisierte Schutz anscheinend nicht zuverlässig gemeldet hatte.
Das zugrunde liegende Problem war erstaunlich ähnlich. Die Organisation konnte den Regelkreis zwischen einer Veränderung in der kritischen Umgebung und einem wirksamen Eingriff nicht zuverlässig schließen.
Dieser Regelkreis benötigt weit mehr als einen Sensor. Er benötigt:
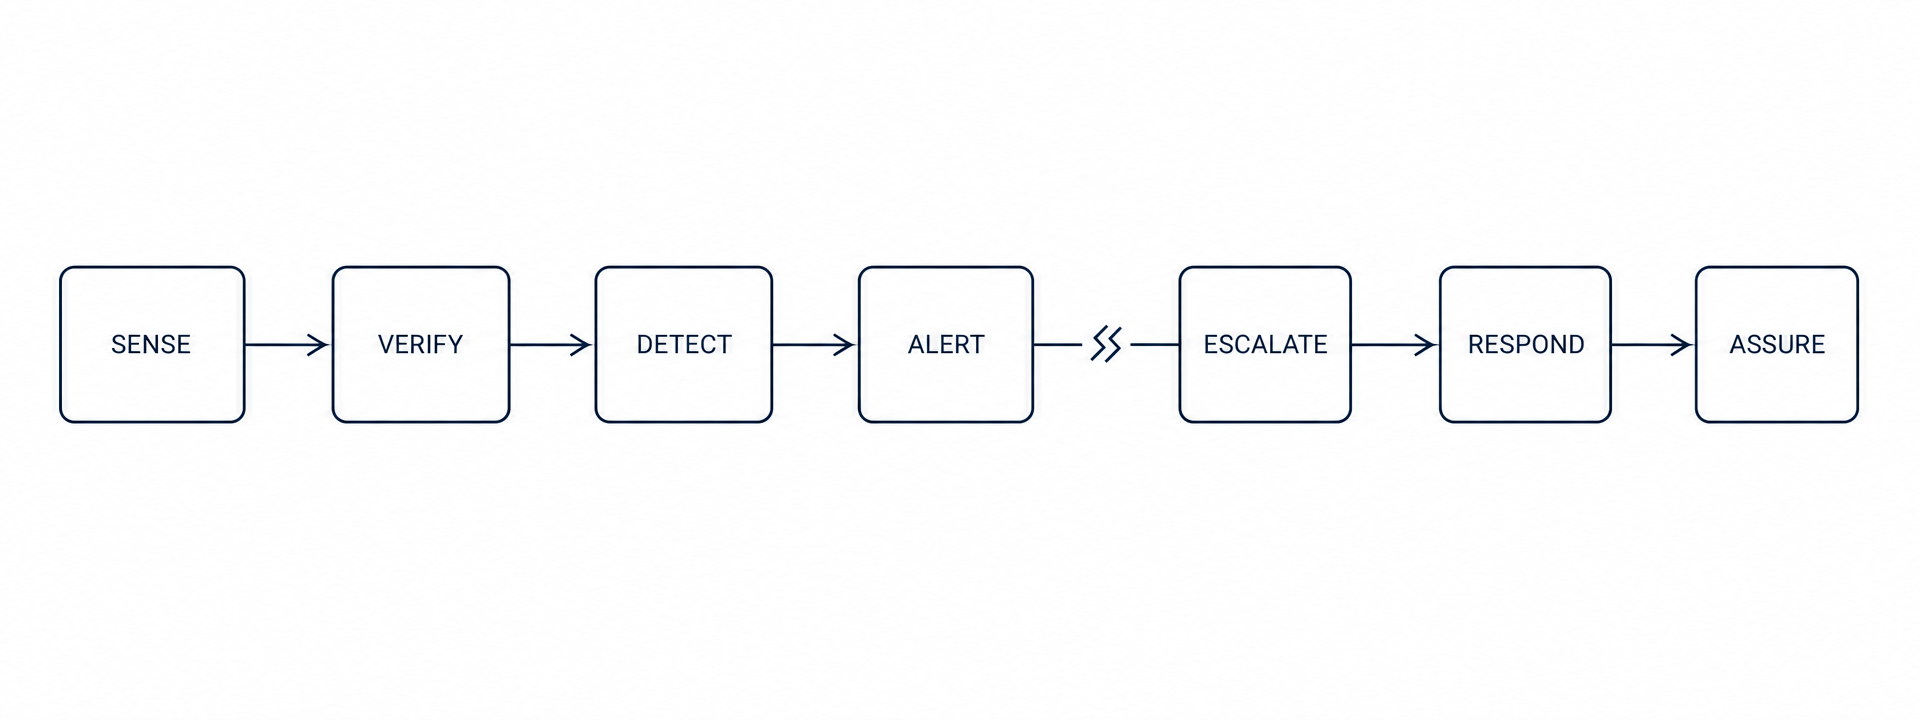
Und jedes Glied ist wichtig:
- ein Ventil kann geschlossen werden
- ein Tank kann Stickstoff verlieren
- ein Sensor kann ausfallen
- eine Netzwerkverbindung kann unterbrochen werden
- ein Alarm kann deaktiviert werden
- eine Telefonnummer kann veraltet sein, eine E-Mail kann im Spam-Ordner landen, ein Wartungseingriff kann den Zustand eines Systems ändern
- die verantwortliche Person kann nicht erreichbar sein
- ein früherer Alarm kann zu Alarmmüdigkeit führen
Keines dieser Ereignisse ist für sich allein genommen zwangsläufig katastrophal. Die Katastrophe ereignet sich, wenn die Organisation die Ereigniskette nicht erkennen, verstehen und darauf reagieren kann, bevor die verbleibende Sicherheitsmarge aufgebraucht ist.
Die Grenzen der herkömmlichen Umgebungsüberwachung
Die traditionelle Umgebungsüberwachung beruht auf einer einfachen Annahme: Messen Sie die Umgebung und lösen Sie einen Alarm aus, wenn ein Schwellenwert überschritten wird.
Dieses Modell bleibt unerlässlich, aber kritische Umgebungen erfordern mehr. Betrachten Sie das Karolinska-Institut. Eine alleinige Überwachung der Temperatur der kryogenen Tanks hätte das Problem erst erkannt, nachdem die LN₂-Versorgung bereits unterbrochen war und die Reserve zu schwinden begann.
Ein widerstandsfähigerer Ansatz fragt auch:
- Funktioniert die LN₂-Versorgung?
- Arbeitet das Nachfüllsystem?
- Hat ein Wartungseingriff den Zustand des Systems verändert?
- Findet das erwartete Nachfüllen tatsächlich statt?
- Ist das Alarmsystem selbst betriebsbereit?
- Erhalten die richtigen Personen die Alarmmeldungen?
- Hat jemand das Ereignis quittiert?
- Was passiert, wenn niemand reagiert?
- Gibt es eine 24/7-Eskalation?
- Kann die Organisation nachweisen, was passiert ist?
Dies ist der Unterschied zwischen der Messung einer Umgebung und der Sicherstellung einer Umgebung.
Von der Umgebungsüberwachung zur betrieblichen Sicherheit
Die betriebliche Sicherheit geht von einer anderen Frage aus. Nicht „Wie ist die Temperatur?“, sondern „Können wir nachweisen, dass diese kritische Umgebung unter Kontrolle bleibt?“
Das erfordert eine unabhängige Ebene, die Infrastruktur, Daten, Technologie und Menschen miteinander verbindet. Es bedeutet, nicht nur den Zustand der Umgebung kontinuierlich zu verstehen, sondern auch den Zustand des Systems, das für den Schutz dieser Bedingung verantwortlich ist. In der Praxis:
- Erkennen von abnormalen Mustern
- Feststellen von Kommunikationsverlusten
- Überprüfen, dass Alarme betriebsbereit sind
- Wissen, wer für ein kritisches Ereignis verantwortlich ist
- Eskalieren, wenn eine Alarmmeldung nicht quittiert wird
- Führen eines auditierbaren Protokolls darüber, was passiert ist und wie die Organisation reagiert hat
- Erkennen, dass die wichtigste Warnung eintreffen kann, bevor der endgültige Umgebungsparameter seinen kritischen Schwellenwert überschreitet
Das Ziel ist nicht, zu versprechen, dass Geräte niemals ausfallen werden. Geräte werden ausfallen. Das Ziel ist es, sicherzustellen, dass ein Geräteausfall nicht unbemerkt zu einem Verlust von Werten wird.
Worin sich XiltriX Resilience unterscheidet
XiltriX Resilience wurde nach diesem Prinzip konzipiert. Anstatt die Umgebungsüberwachung als eine Ansammlung von Sensoren, Alarmen und Dashboards zu betrachten, schafft es eine unabhängige Ebene der betrieblichen Sicherheit um kritische Umgebungen herum, die drei wesentliche Elemente miteinander verbindet.
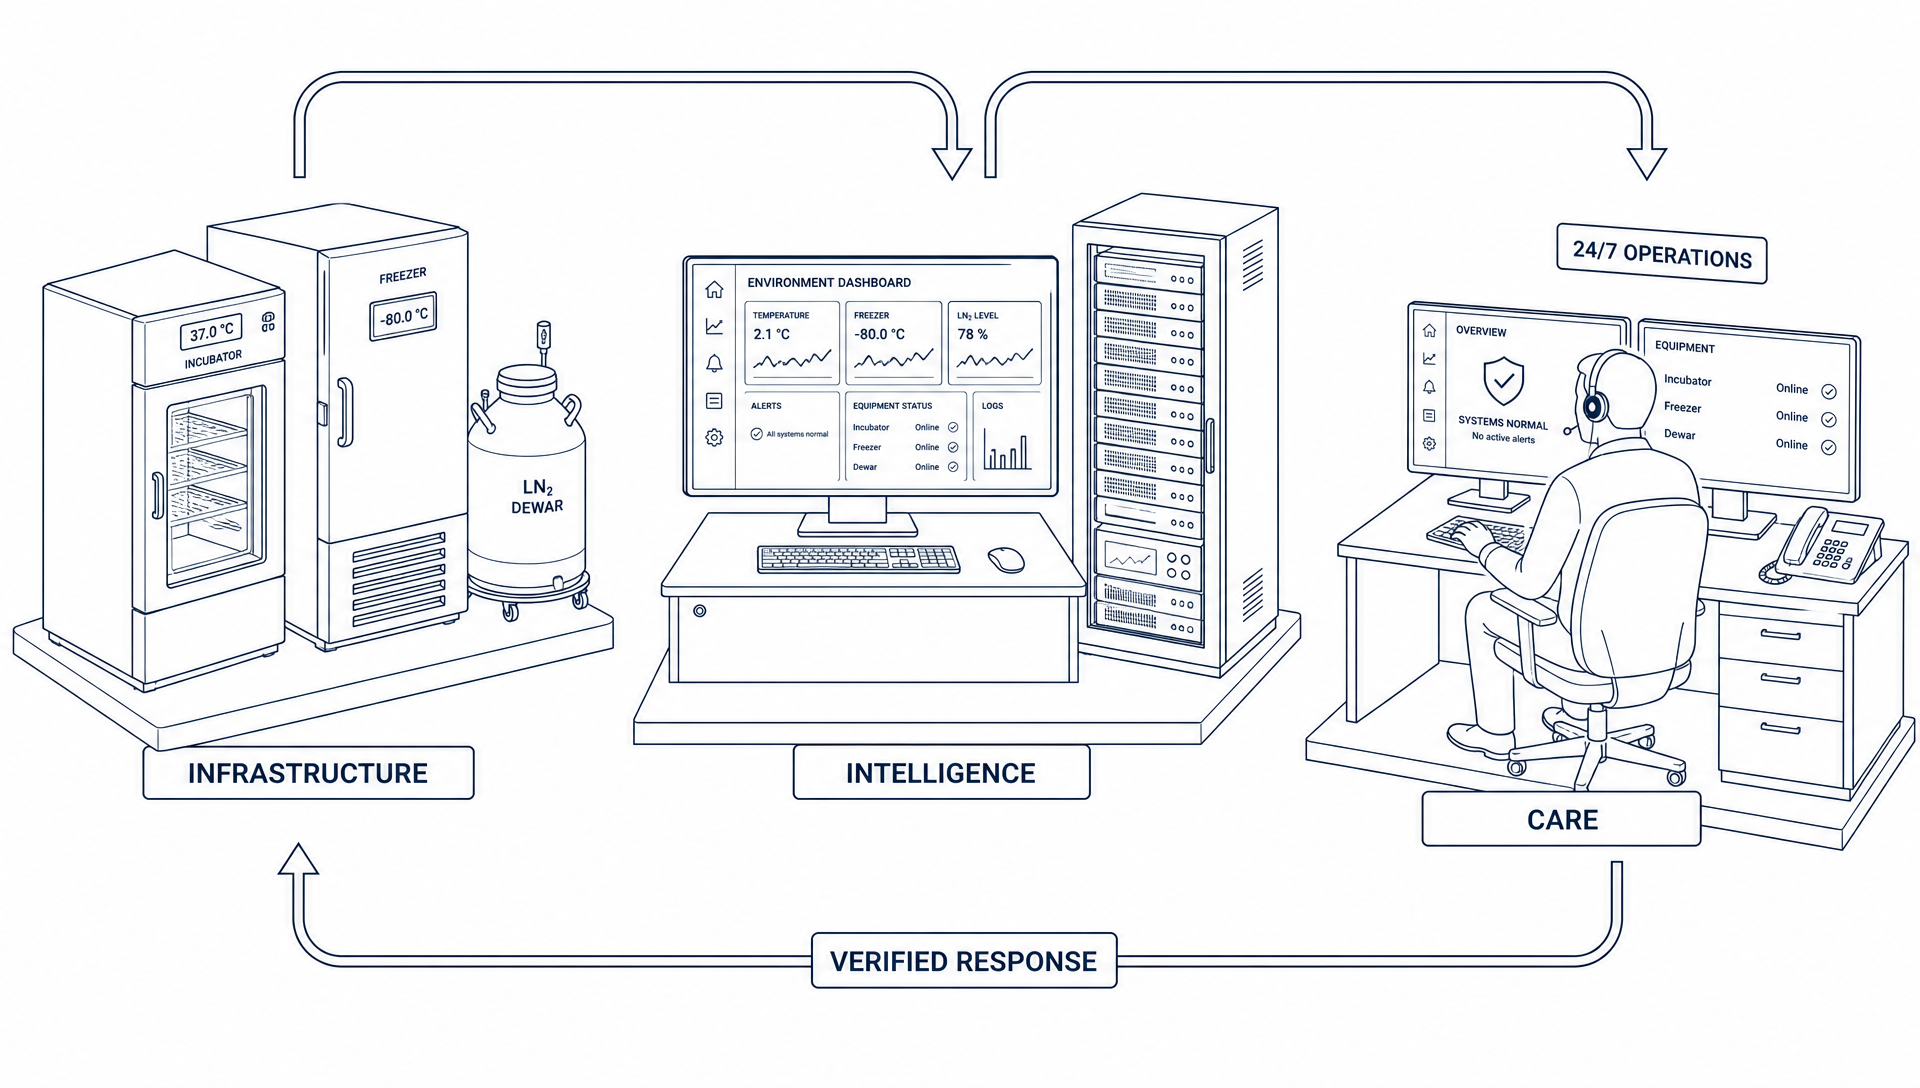
Infrastructure. Die physischen Systeme und Anlagen, die die erforderliche Umgebung schaffen und aufrechterhalten.
Intelligence. Die kontinuierliche Erfassung, Validierung und Interpretation von Umgebungs- und Betriebsdaten, die nicht nur Abweichungen, sondern auch Muster, Anomalien und Ausfälle in der Überwachungskette selbst identifiziert.
Care. Die Menschen, Prozesse und Verantwortlichkeiten, die ein erkanntes Problem in eine angemessene Reaktion umwandeln, anstatt in einen weiteren unbeantworteten Alarm.
Zusammen bilden sie einen geschlossenen Sicherungsregelkreis:
Infrastructure → Intelligence → Alarmierung → Eskalation → Care → Verifizierte Reaktion
Dies unterscheidet sich grundlegend von der Installation von mehr Sensoren. Die Lehre aus den Vorfällen am Karolinska-Institut, in Cleveland und im Pacific Fertility Center ist nicht, dass Labore mehr Daten benötigen. Sie benötigen die Gewissheit, dass den Daten, der Infrastruktur und dem Reaktionssystem vertraut werden kann, wenn es am wichtigsten ist.
Gewöhnliche Ereignisse, unumkehrbare Folgen
Die drei in diesem Artikel beschriebenen Vorfälle wurden nicht durch einen einzigen außergewöhnlichen Ausfall verursacht. Sie entstanden aus gewöhnlichen Ereignissen:
- ein Wartungseingriff
- ein geschlossenes Ventil
- eine aufgebrauchte Reserve
- ein deaktivierter Alarm
- ein ausgefallener Erkennungsmechanismus
- eine unvollständige Reaktion
Genau deshalb sind sie von Bedeutung. Kritische Laborumgebungen fallen nicht nur aus, wenn etwas Spektakuläres passiert. Sie fallen aus, wenn sich kleine Abweichungen ansammeln, ohne erkannt, verstanden oder behandelt zu werden.
Bei der betrieblichen Sicherheit geht es darum, diese unsichtbaren Ketten sichtbar zu machen und sie zu unterbrechen, bevor sie unumkehrbar werden.
Darum geht es bei XiltriX Resilience. Nicht nur darum, Ihnen mitzuteilen, wann sich die Umgebung geändert hat, sondern darum, kontinuierliches Vertrauen zu schaffen, dass die Umgebung, das Überwachungssystem und der Reaktionsprozess zusammenarbeiten, um das zu schützen, was nicht ersetzt werden kann.
Nothing left to chance.
Besuchen Sie uns auf der WOTS 2026
XiltriX wird auf der WOTS, der World of Industry, Technology & Science, vom 22. bis 25. September 2026 in der Jaarbeurs Utrecht, Stand 11B006, vertreten sein. Überzeugen Sie sich selbst davon, was betriebliche Widerstandsfähigkeit in der Praxis bedeutet und wie XiltriX Resilience die Sicherheit von Werten und Prozessen gewährleistet.