Bij het Karolinska Institutet, het Cleveland Fertility Center en het Pacific Fertility Center werden in geavanceerde laboratoria de omgevingen gemonitord die ontworpen waren om onvervangbaar biologisch materiaal te beschermen. Toch gingen duizenden monsters verloren. Niet omdat er geen monitoring was, maar omdat monitoring alleen niet voldoende was.
Deze incidenten leggen een fundamentele zwakte bloot in de manier waarop kritieke laboratoriumomgevingen vaak worden beschermd. Sensoren meten. Alarmen waarschuwen. Dashboards tonen informatie. Maar als er iets misgaat, garandeert niets daarvan dat de juiste persoon het op tijd zal weten, begrijpen, de verantwoordelijkheid zal nemen en zal handelen.
Het verschil tussen monitoring en operationele zekerheid kan worden gemeten aan wat er vervolgens gebeurt.
Karolinska Institutet: de storing begon voordat de temperatuur veranderde
In december 2023 kreeg het Karolinska Institutet te maken met een catastrofale storing van de cryogene opslaginfrastructuur in zijn Neo-faciliteit in Stockholm. Uiteindelijk gingen ongeveer 47.100 biologische monsters, die over tientallen jaren waren verzameld, verloren.
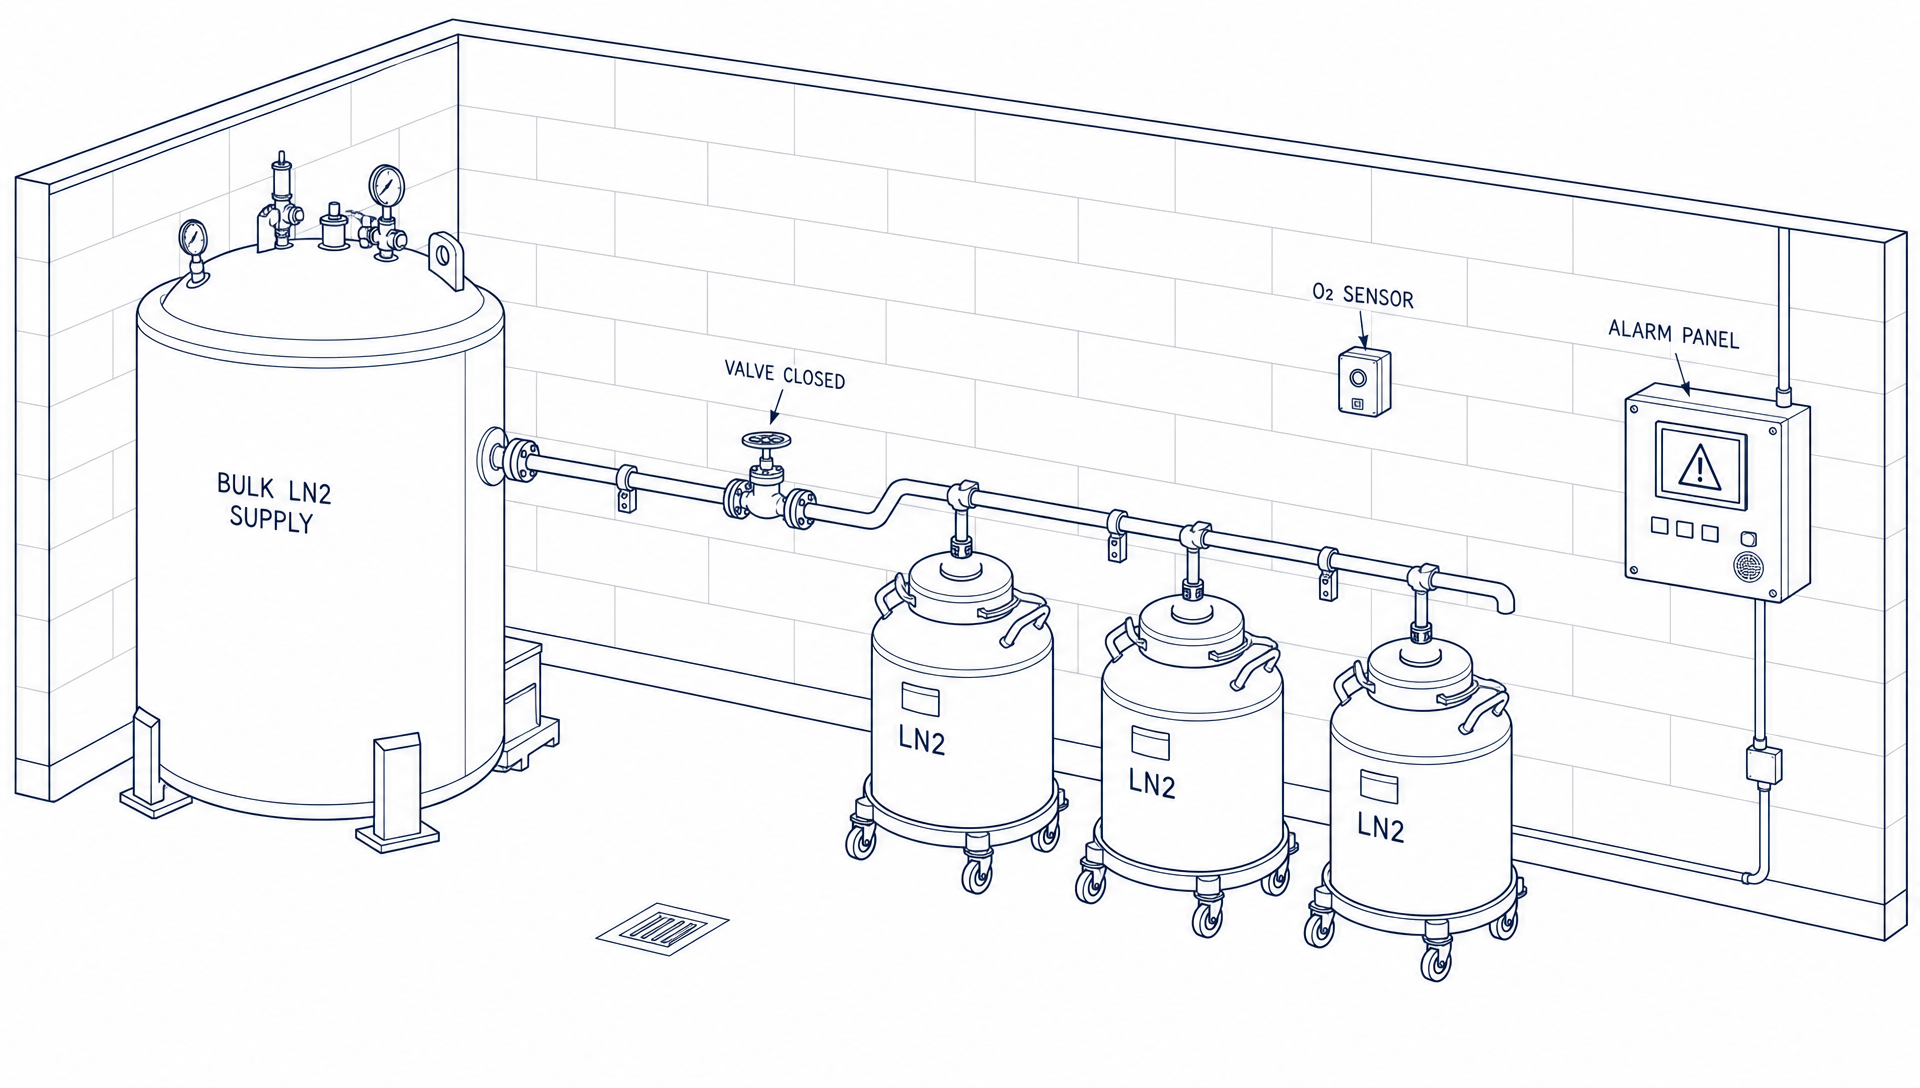
Het onderzoek is onthullend, juist omdat het incident niet begon met een vriezer die plotseling te warm werd. Tijdens gepland onderhoud werd een alarm voor het zuurstofniveau geactiveerd. Daardoor werd de klep van de bulktank voor vloeibare stikstof gesloten en de toevoer naar de cryogene opslagtanks onderbroken. De toevoer werd nooit hersteld.
De afzonderlijke tanks hadden genoeg reserve om een tijd door te gaan, dus hun vloeibare stikstofniveaus daalden geleidelijk. Pas later verslechterden de omstandigheden in de tanks. De volgorde was in feite:
Onderhoudsgebeurtenis → LN₂-toevoer onderbroken → reserve uitgeput → omstandigheden verslechterd → alarmen gegenereerd → interventie mislukt → monsters verloren.
De analyse achteraf bracht een keten van technische en organisatorische tekortkomingen aan het licht, in plaats van één enkele, geïsoleerde fout. Verantwoordelijkheden waren onduidelijk. De communicatie en het delen van informatie waren ontoereikend. Het testen van alarmen was onvoldoende. Contactgegevens waren verouderd. Eerdere incidenten waren niet goed gedocumenteerd en de organisatie had geen effectieve 24/7-responscapaciteit tijdens de kerstperiode.
De alarmen waren niet simpelweg afwezig. Er werden signalen gegenereerd. Er werden berichten verzonden. Wat de organisatie miste, was een betrouwbaar mechanisme om die signalen om te zetten in een geverifieerde respons.
De les is diepgaand: een alarm is geen controlesysteem. Het is één schakel in een controlesysteem.
Cleveland Fertility Center: toen het vangnet werd uitgeschakeld
In maart 2018 vond in het University Hospitals Fertility Center in Cleveland een incident plaats met cryogene opslag, dat meer dan 4.000 eicellen en embryo's van ongeveer 950 patiënten trof.
De opslagtank had een alarm op afstand dat bedoeld was om het personeel te waarschuwen wanneer de omstandigheden verslechterden. Het alarm was uitgeschakeld. Het ziekenhuis kon niet vaststellen wanneer of door wie het was uitgeschakeld. De tank had ook problemen met het vulsysteem voor vloeibare stikstof. Toen de opslagomstandigheden verslechterden, bood de verwachte waarschuwing op afstand simpelweg niet de bescherming waarvoor deze bedoeld was.
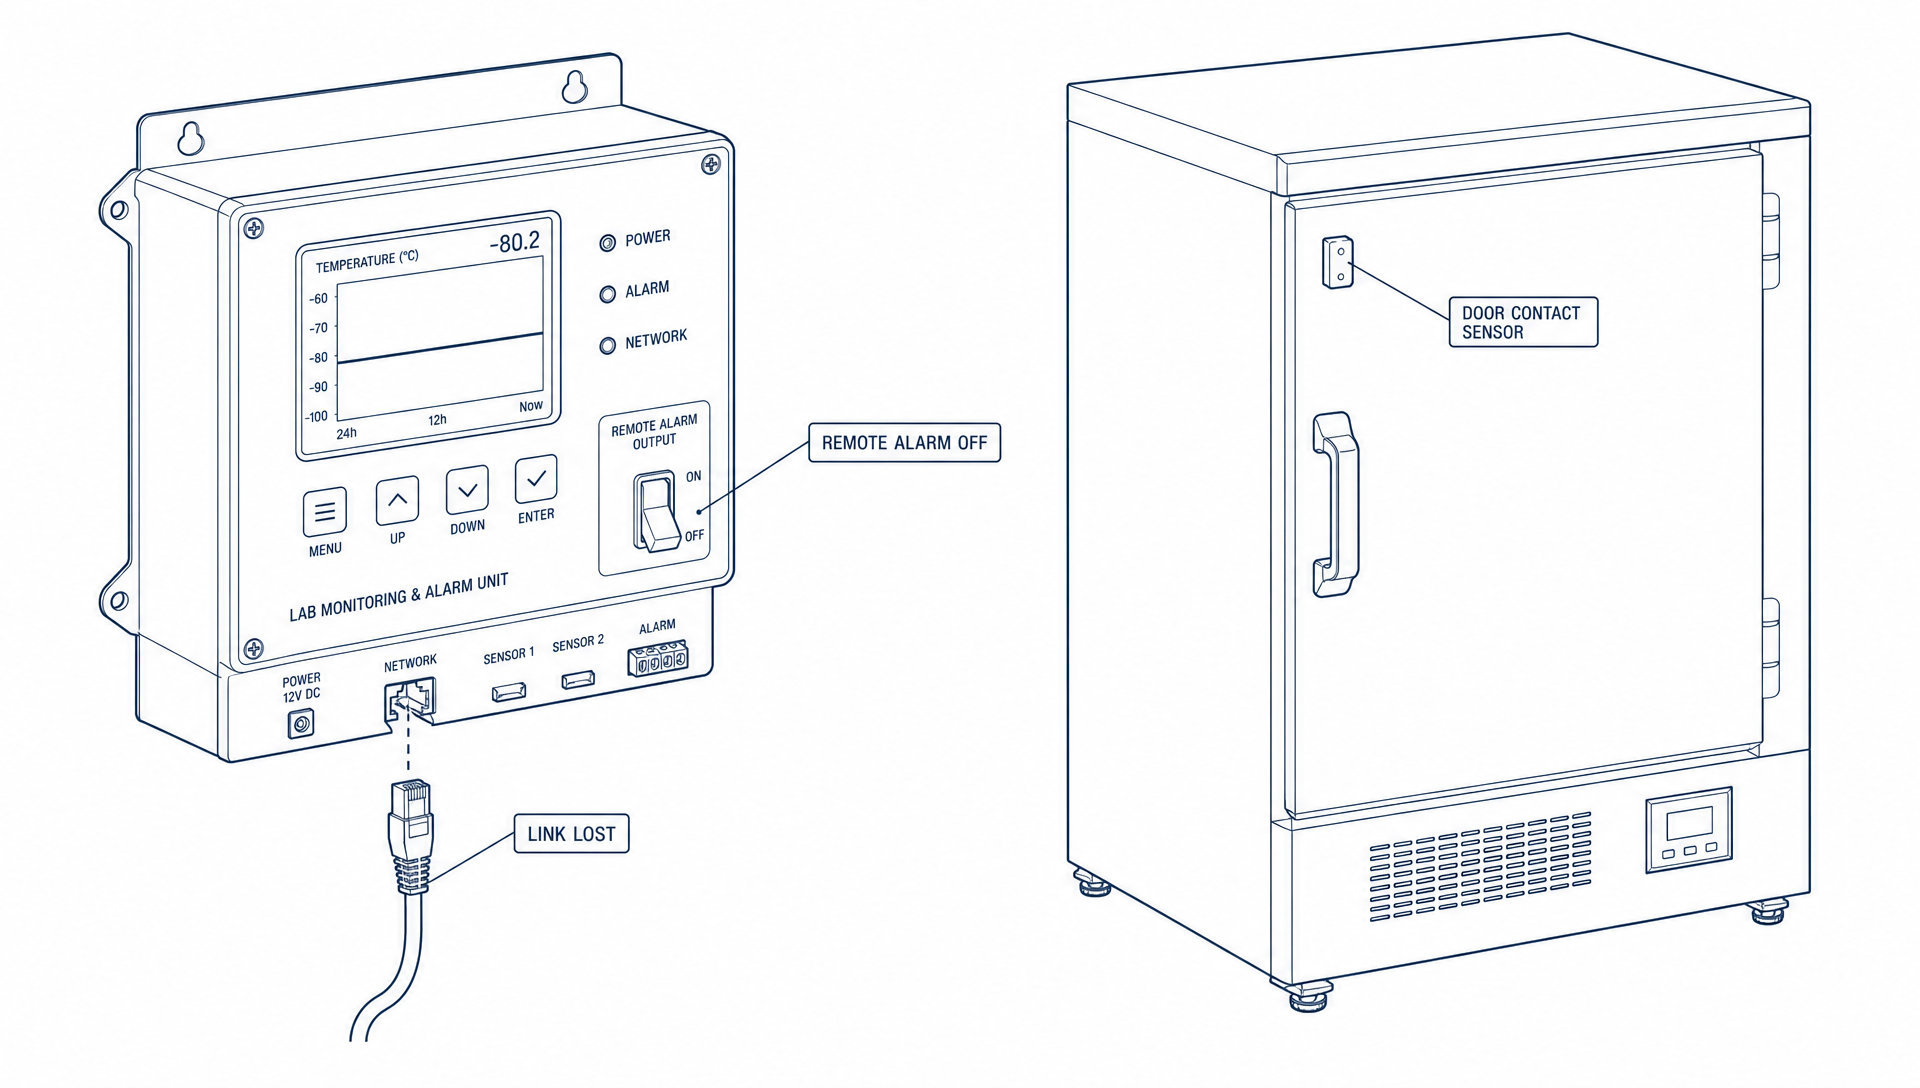
Dit is een andere zwakte dan bij Karolinska. De vraag was niet of er een alarm bestond, maar of de organisatie wist dat het alarm zelf beschikbaar, verbonden en operationeel was.
Een monitoringsysteem dat ongemerkt onbeschikbaar kan worden, creëert iets dat gevaarlijker is dan helemaal geen monitoring: een vals gevoel van vertrouwen.
Pacific Fertility Center: de mens werd de laatste verdedigingslinie
Op dezelfde dag als het incident in Cleveland, kreeg het Pacific Fertility Center in San Francisco te maken met een storing in de cryogene opslag in een tank die ongeveer 2.500 embryo's en 1.500 eicellen bevatte.
Deze casus leert de tegenovergestelde les. Een embryoloog ontdekte tijdens een fysieke controleronde dat het vloeibare stikstofniveau in een tank gevaarlijk laag was geworden. Het team reageerde onmiddellijk en bracht het materiaal over naar een andere tank. Menselijke inspectie werd de kritieke veiligheidsbarrière.
De daaropvolgende onderzoeken bestudeerden het falen van de tank en de betrouwbaarheid en redundantie van de monitoring- en alarmsystemen. Gedetailleerde rapportage benadrukte een probleem waarmee elke vruchtbaarheidskliniek en cryogene faciliteit wordt geconfronteerd: geen enkele afzonderlijke voorzorgsmaatregel mag als onfeilbaar worden beschouwd.
De les is niet dat menselijke inspectie onnodig is. Het is dat menselijke inspectie niet de laatste verdediging zou moeten zijn tegen een storing die een onafhankelijk monitoringsysteem zou moeten detecteren.
Drie incidenten, drie storingsmodi, één probleem
Technisch gezien waren de drie gevallen zeer verschillend.
- Bij Karolinska werd de toevoer naar de gecontroleerde omgeving onderbroken en slaagde de organisatie er niet in deze op tijd te herstellen.
- Bij Cleveland was het alarmsysteem op afstand zelf niet beschikbaar.
- Bij Pacific Fertility werd een verslechterende toestand opgemerkt door menselijke observatie, die de geautomatiseerde beveiliging blijkbaar niet betrouwbaar aan het licht bracht.
Het onderliggende probleem was opmerkelijk vergelijkbaar. De organisatie kon de kringloop tussen een verandering in de kritieke omgeving en een effectieve interventie niet betrouwbaar sluiten.
Die kringloop heeft veel meer nodig dan een sensor. Het heeft nodig:
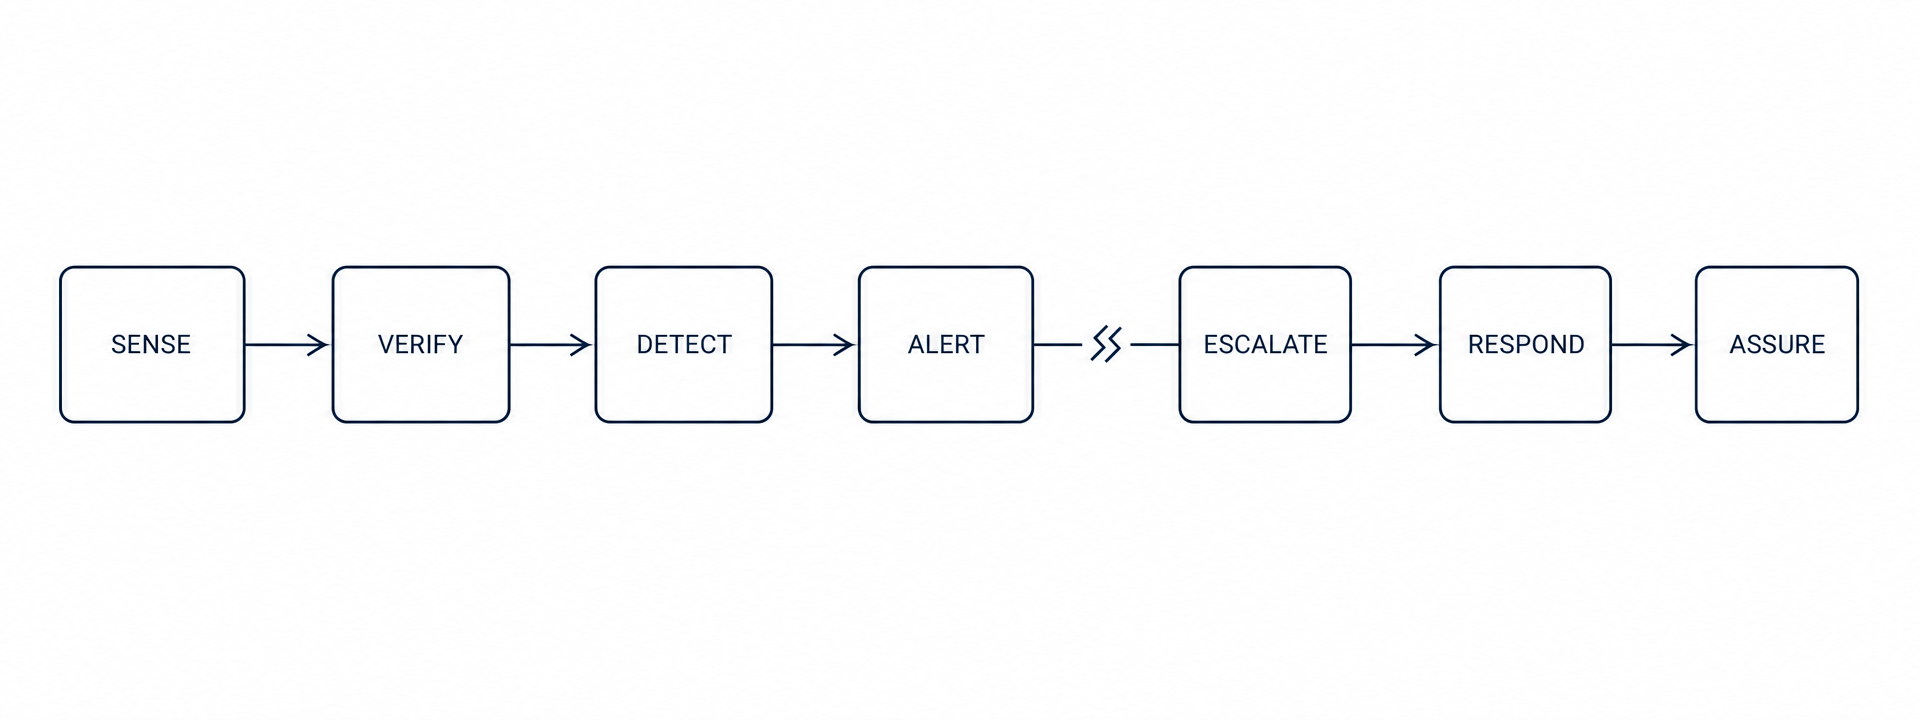
En elke schakel is van belang:
- een klep kan gesloten zijn
- een tank kan stikstof verliezen
- een sensor kan defect raken
- een netwerkverbinding kan wegvallen
- een alarm kan worden uitgeschakeld
- een telefoonnummer kan verouderd zijn, een e-mail kan in een map met ongewenste e-mail belanden, een onderhoudsinterventie kan de status van een systeem veranderen
- de verantwoordelijke persoon kan onbereikbaar zijn
- een eerder alarm kan alarmmoeheid veroorzaken
Geen van deze gebeurtenissen is op zichzelf noodzakelijkerwijs catastrofaal. De catastrofe vindt plaats wanneer de organisatie de keten van gebeurtenissen niet kan detecteren, begrijpen en erop reageren voordat de resterende veiligheidsmarge is uitgeput.
De beperkingen van conventionele omgevingsmonitoring
Traditionele omgevingsmonitoring berust op een eenvoudig uitgangspunt: meet de omgeving en sla alarm wanneer een drempelwaarde wordt overschreden.
Dat model blijft essentieel, maar kritieke omgevingen vragen om meer. Neem Karolinska. Alleen het monitoren van de temperatuur van de cryogene tanks zou het probleem pas hebben gedetecteerd nadat de LN₂-toevoer al was onderbroken en de reserve begon te slinken.
Een weerbaarheidigere aanpak vraagt ook:
- Functioneert de LN₂-toevoer?
- Werkt het vulsysteem?
- Heeft een onderhoudsinterventie de status van het systeem veranderd?
- Vindt de verwachte vulling ook daadwerkelijk plaats?
- Is het alarmsysteem zelf operationeel?
- Ontvangen de juiste mensen de meldingen?
- Heeft iemand de gebeurtenis bevestigd?
- Wat gebeurt er als niemand reageert?
- Is er 24/7-escalatie?
- Kan de organisatie bewijzen wat er is gebeurd?
Dit is het verschil tussen het meten van een omgeving en het zekerstellen van een omgeving.
Van omgevingsmonitoring naar operationele zekerheid
Operationele zekerheid begint met een andere vraag. Niet "wat is de temperatuur?", maar "kunnen we aantonen dat deze kritieke omgeving onder controle blijft?"
Dat vereist een onafhankelijke laag die infrastructuur, data, technologie en mensen met elkaar verbindt. Het betekent voortdurend inzicht hebben in niet alleen de omgevingsconditie, maar ook de gezondheid van het systeem dat verantwoordelijk is voor het beschermen van die conditie. In de praktijk:
- het herkennen van abnormale patronen
- het detecteren van communicatieverlies
- het verifiëren dat alarmen operationeel zijn
- weten wie eigenaar is van een kritieke gebeurtenis
- escaleren wanneer een melding niet wordt bevestigd
- het bijhouden van een auditeerbaar verslag van wat er is gebeurd en hoe de organisatie heeft gereageerd
- het erkennen dat de belangrijkste waarschuwing kan komen voordat de uiteindelijke omgevingsparameter zijn kritieke drempelwaarde overschrijdt
Het doel is niet om te beloven dat apparatuur nooit zal falen. Apparatuur zal falen. Het doel is om ervoor te zorgen dat een storing van apparatuur niet ongemerkt leidt tot het verlies van assets.
Waarin XiltriX Resilience anders is
XiltriX Resilience is ontworpen rond dit principe. In plaats van omgevingsmonitoring te beschouwen als een verzameling sensoren, alarmen en dashboards, creëert het een onafhankelijke operationele zekerheidslaag rond kritieke omgevingen, die drie essentiële elementen met elkaar verbindt.
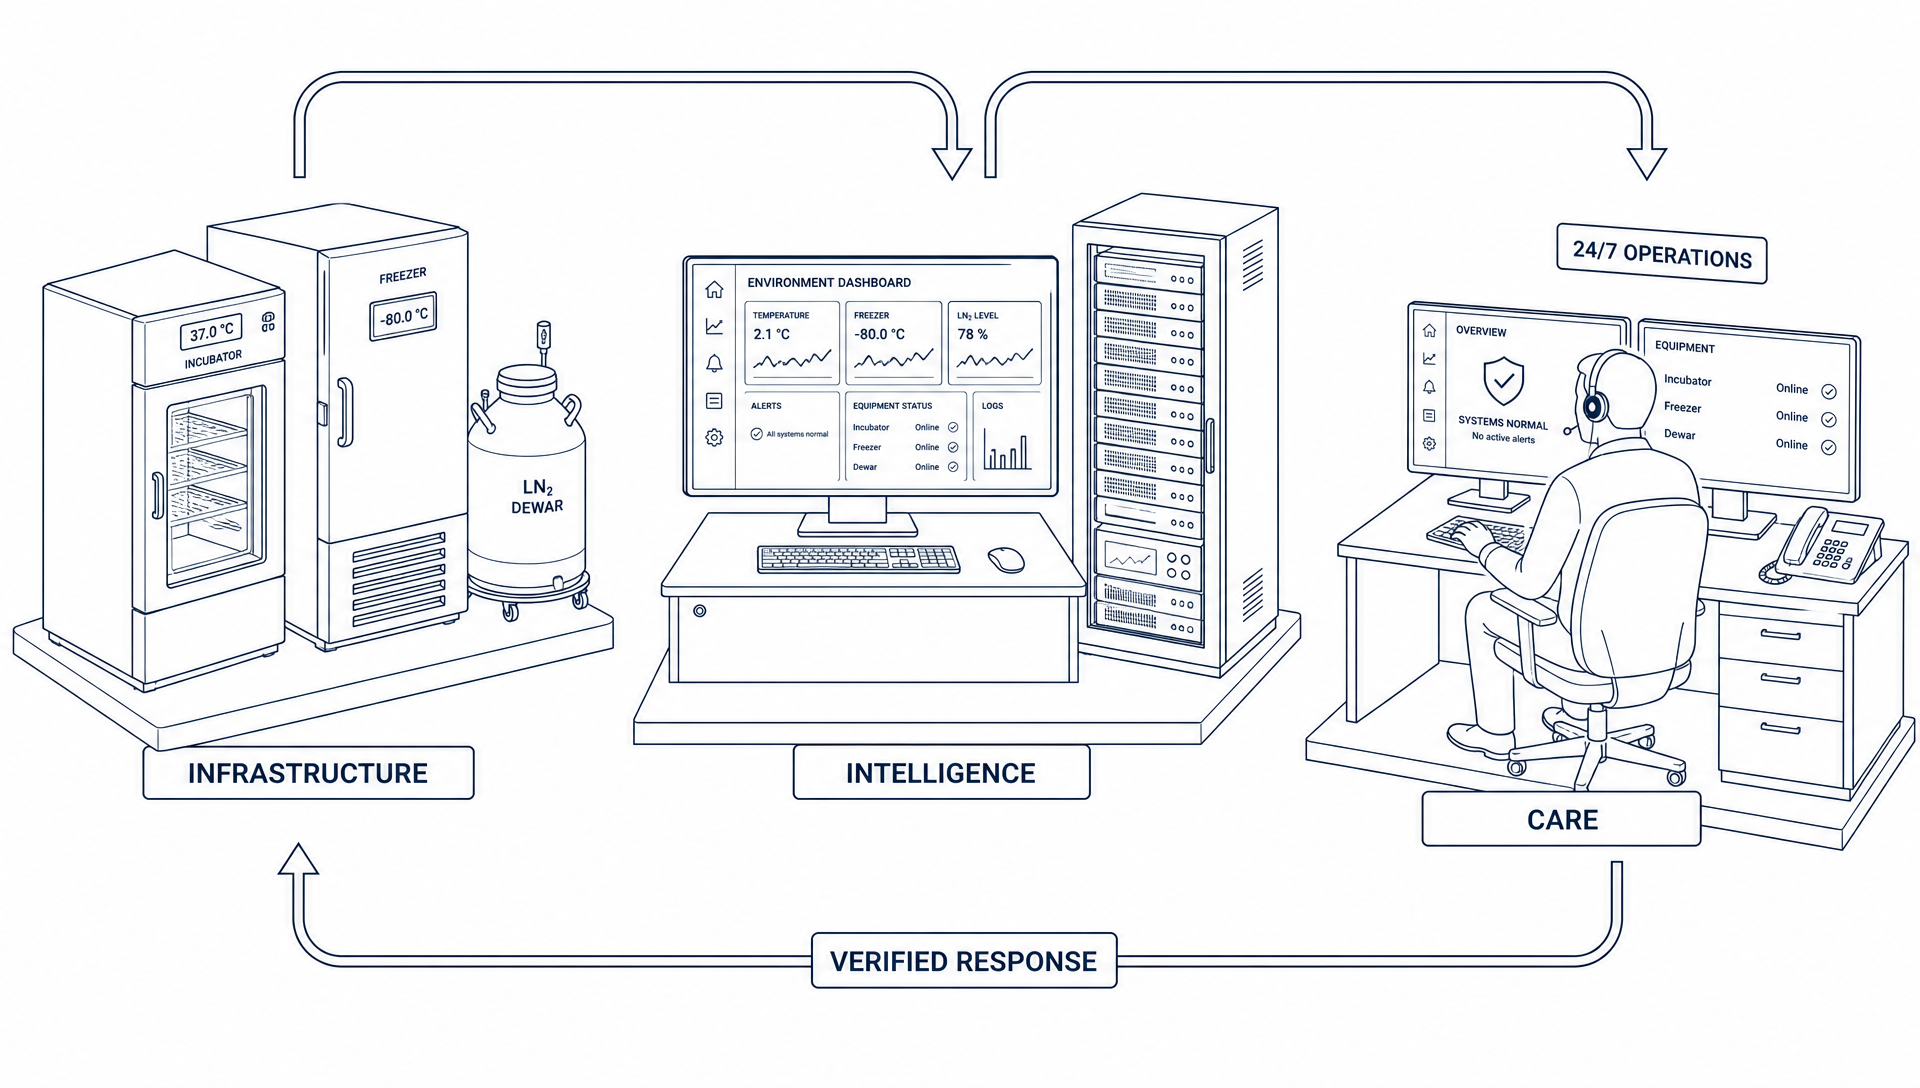
Infrastructure. De fysieke systemen en assets die de vereiste omgeving creëren en in stand houden.
Intelligence. De continue verzameling, validatie en interpretatie van omgevings- en operationele data, waarbij niet alleen afwijkingen worden geïdentificeerd, maar ook patronen, afwijkingen en storingen in de monitoringketen zelf.
Care. De mensen, processen en verantwoordelijkheid die een gedetecteerd probleem omzetten in een passende respons in plaats van weer een onbeantwoord alarm.
Samen vormen ze een gesloten zekerheidskringloop:
Infrastructure → Intelligence → Alert → Escalation → Care → Verified response
Dit is fundamenteel anders dan het installeren van meer sensoren. De les van Karolinska, Cleveland en Pacific Fertility is niet dat laboratoria meer data nodig hebben. Ze hebben het vertrouwen nodig dat de data, de infrastructuur en het responssysteem te vertrouwen zijn wanneer het er het meest op aankomt.
Gewone gebeurtenissen, onomkeerbare gevolgen
De drie incidenten in dit artikel werden niet veroorzaakt door één buitengewone storing. Ze kwamen voort uit gewone gebeurtenissen:
- een onderhoudsinterventie
- een gesloten klep
- een uitgeputte reserve
- een uitgeschakeld alarm
- een falend detectiemechanisme
- een onvolledige respons
Dat is precies waarom ze van belang zijn. Kritieke laboratoriumomgevingen falen niet alleen wanneer er iets spectaculairs gebeurt. Ze falen wanneer kleine afwijkingen zich opstapelen zonder te worden gedetecteerd, begrepen of opgevolgd.
Operationele zekerheid gaat over het zichtbaar maken van die onzichtbare ketens en het onderbreken ervan voordat ze onomkeerbaar worden.
Dat is waar XiltriX Resilience om draait. Niet alleen u vertellen wanneer de omgeving is veranderd, maar continu vertrouwen bieden dat de omgeving, het monitoringsysteem en het responsproces allemaal samenwerken om te beschermen wat onvervangbaar is.
Nothing left to chance.
Ontmoet ons op WOTS 2026
XiltriX is aanwezig op WOTS, World of Industry, Technology & Science, van 22 tot en met 25 september 2026 in de Jaarbeurs Utrecht, stand 11B006. Kom en zie wat operationele weerbaarheid in de praktijk betekent en hoe XiltriX Resilience zekerheid biedt voor assets en processen.