En el Instituto Karolinska, el Cleveland Fertility Center y el Pacific Fertility Center, laboratorios sofisticados monitorizaban entornos diseñados para proteger material biológico irremplazable. Aun así, se perdieron miles de muestras. No porque nadie estuviera monitorizando, sino porque la monitorización por sí sola no era suficiente.
Estos incidentes exponen una debilidad fundamental en la forma en que a menudo se protegen los entornos de laboratorio críticos. Los sensores miden. Las alarmas avisan. Los paneles de control muestran datos. Pero cuando algo va mal, nada de eso garantiza que la persona adecuada lo sepa, lo entienda, asuma la responsabilidad y actúe a tiempo.
La diferencia entre la monitorización y la garantía operativa puede medirse en lo que sucede a continuación.
Instituto Karolinska: el fallo comenzó antes de que cambiara la temperatura
En diciembre de 2023, el Instituto Karolinska sufrió un fallo catastrófico en la infraestructura de almacenamiento criogénico de sus instalaciones Neo en Estocolmo. Finalmente se perdieron aproximadamente 47.100 muestras biológicas, acumuladas durante décadas.
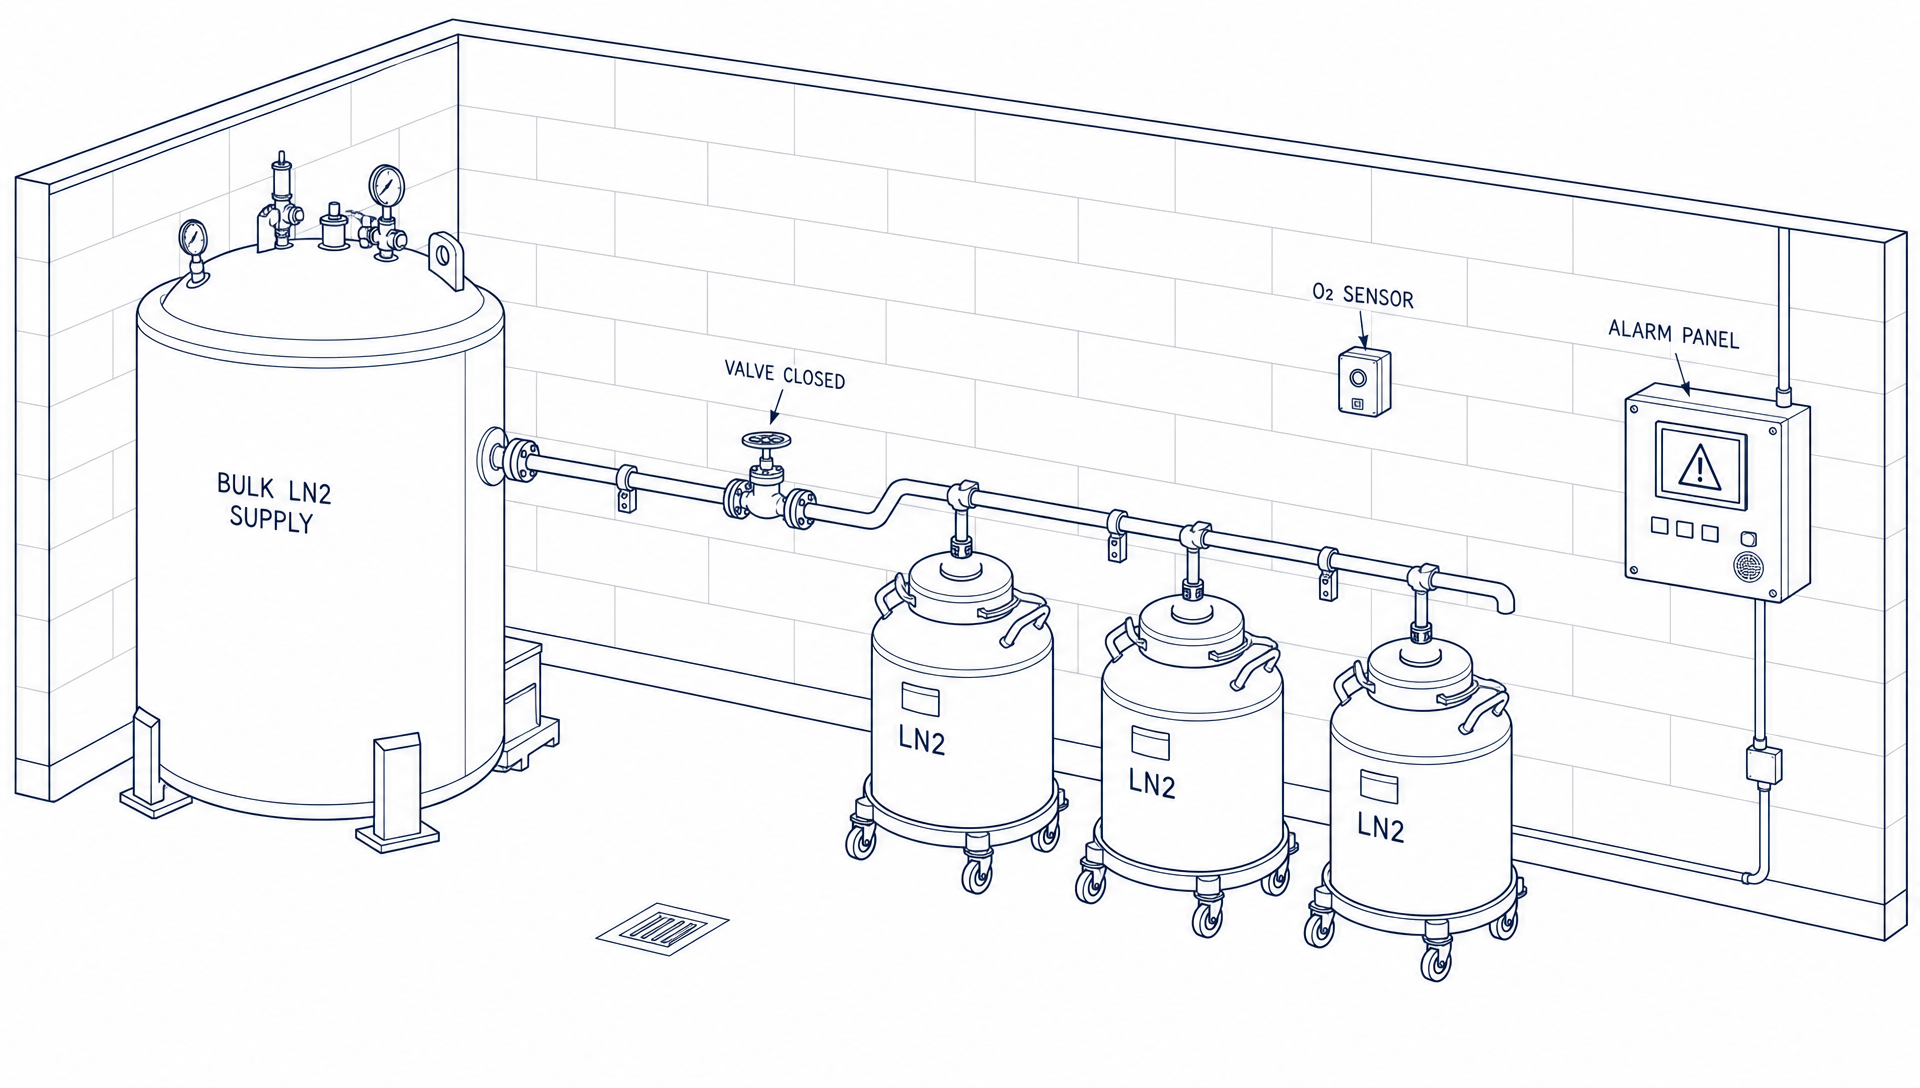
La investigación es reveladora precisamente porque el incidente no comenzó con un congelador que de repente se calentara demasiado. Durante un mantenimiento planificado se activó una alarma de nivel de oxígeno. Esto cerró la válvula del tanque de nitrógeno líquido a granel e interrumpió el suministro a los tanques de almacenamiento criogénico. El suministro nunca se restableció.
Los tanques individuales tenían suficiente reserva para seguir funcionando durante un tiempo, por lo que sus niveles de nitrógeno líquido descendieron gradualmente. Solo más tarde se deterioraron las condiciones dentro de los tanques. La secuencia fue, en efecto:
Evento de mantenimiento → Suministro de LN₂ interrumpido → Reserva agotada → Condiciones deterioradas → Alarmas generadas → Intervención fallida → Muestras perdidas.
El análisis posterior encontró una cadena de deficiencias técnicas y organizativas en lugar de un único error aislado. Las responsabilidades no estaban claras. La comunicación y el intercambio de información eran inadecuados. Las pruebas de las alarmas eran insuficientes. Los datos de contacto no estaban actualizados. Incidentes anteriores no se habían documentado correctamente y la organización no tenía una capacidad de respuesta 24/7 eficaz durante el período navideño.
Las alarmas no es que simplemente no existieran. Se generaron señales. Se enviaron mensajes. Lo que le faltaba a la organización era un mecanismo fiable para convertir esas señales en una respuesta verificada.
La lección es profunda: una alarma no es un sistema de control. Es un eslabón de un sistema de control.
Cleveland Fertility Center: cuando la red de seguridad se desconectó
En marzo de 2018, el University Hospitals Fertility Center de Cleveland sufrió un incidente en su almacenamiento criogénico que afectó a más de 4.000 óvulos y embriones pertenecientes a aproximadamente 950 pacientes.
El tanque de almacenamiento tenía una alarma remota destinada a notificar al personal cuando las condiciones se deterioraban. La alarma se había desconectado. El hospital no pudo determinar cuándo se había desactivado ni quién lo había hecho. El tanque también tenía problemas con su sistema de recarga de nitrógeno líquido. Cuando las condiciones de almacenamiento se deterioraron, la advertencia remota esperada simplemente no proporcionó la protección para la que estaba diseñada.
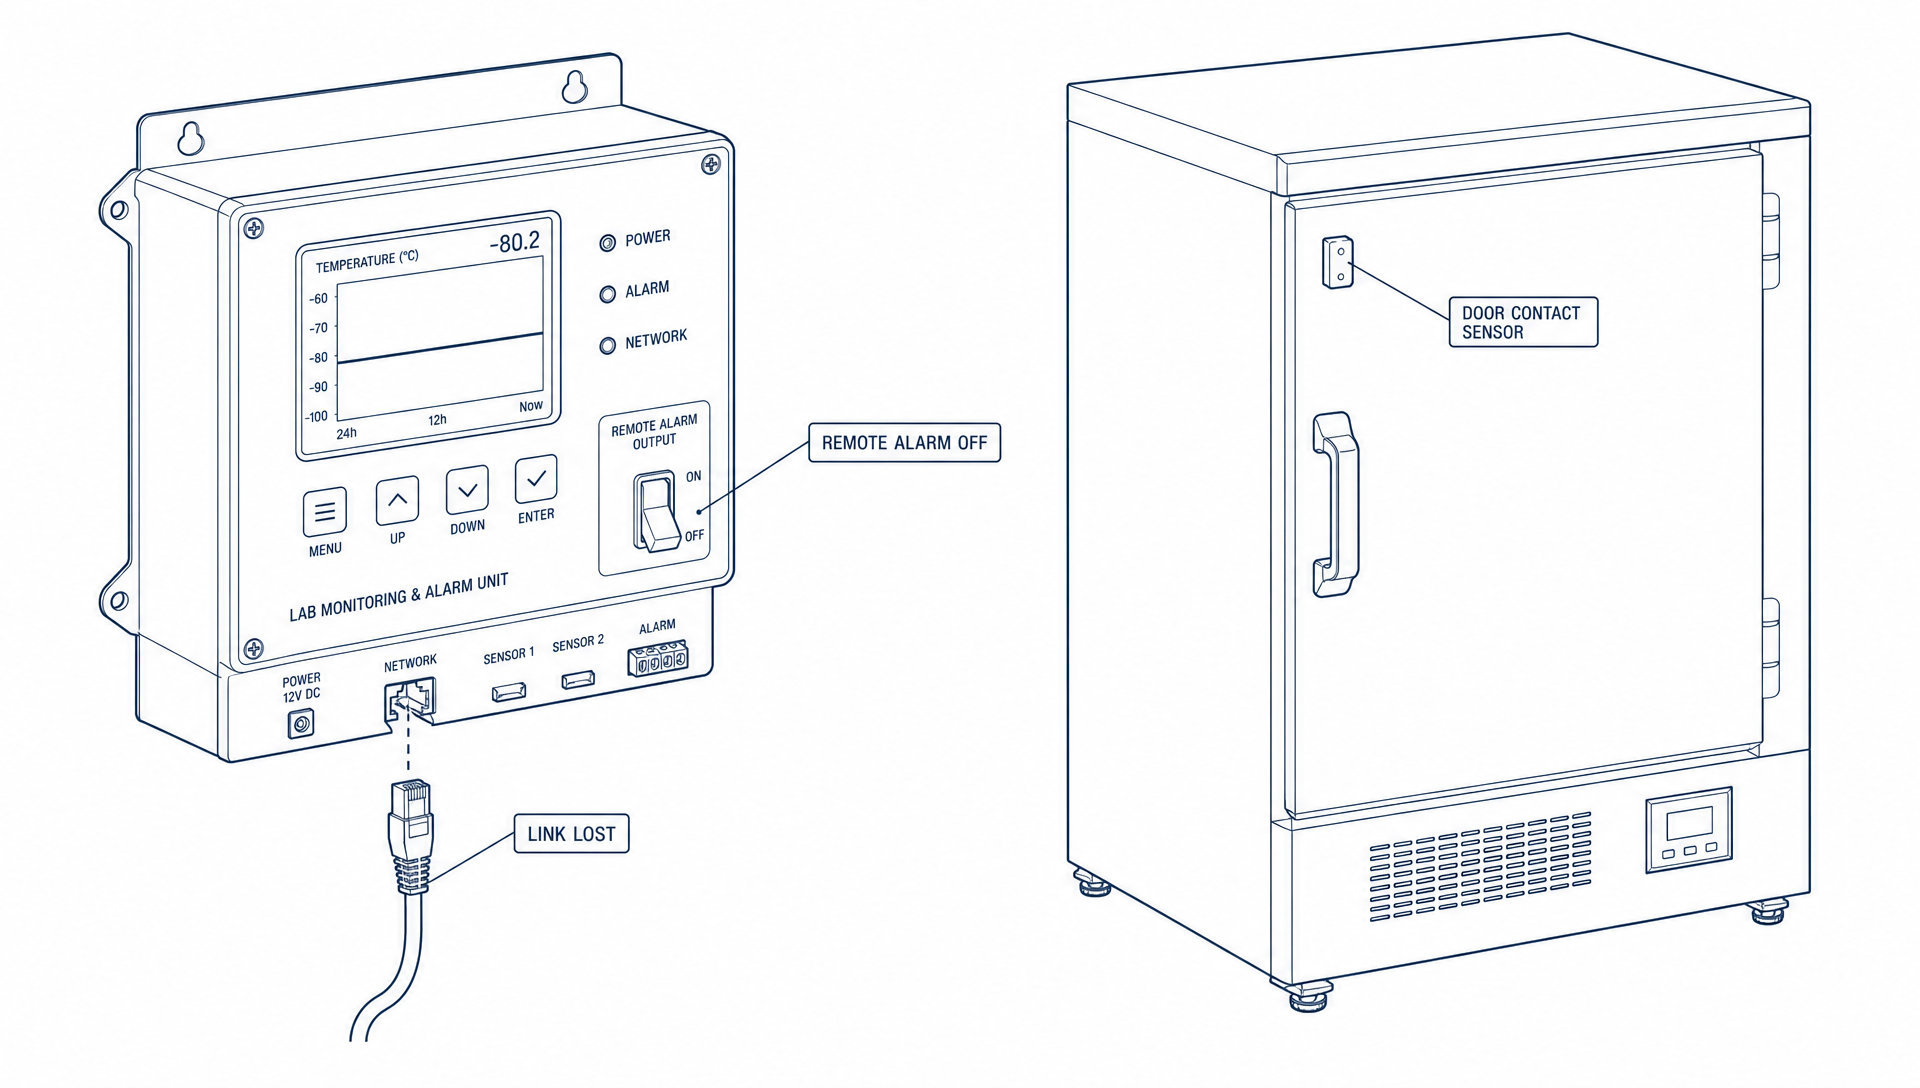
Esta es una debilidad diferente a la del Karolinska. La cuestión no era si existía una alarma, sino si la organización sabía que la propia alarma estaba disponible, conectada y operativa.
Un sistema de monitorización que puede dejar de estar disponible silenciosamente crea algo más peligroso que la ausencia total de monitorización: una falsa confianza.
Pacific Fertility Center: el factor humano se convirtió en la última línea de defensa
El mismo día del incidente de Cleveland, el Pacific Fertility Center de San Francisco sufrió un fallo de almacenamiento criogénico en un tanque que contenía aproximadamente 2.500 embriones y 1.500 óvulos.
Este caso enseña la lección contraria. Un embriólogo descubrió durante una inspección física que el nivel de nitrógeno líquido en uno de los tanques había descendido a un nivel peligrosamente bajo. El equipo respondió inmediatamente y transfirió el material a otro tanque. La inspección humana se convirtió en la barrera de seguridad crítica.
Las investigaciones posteriores examinaron el fallo del tanque y la fiabilidad y redundancia de sus sistemas de monitorización y alarma. Los informes detallados destacaron un problema al que se enfrenta toda clínica de fertilidad e instalación criogénica: no se debe suponer que una única salvaguarda sea infalible.
La lección no es que la inspección humana sea innecesaria. Es que la inspección humana no debería tener que ser la defensa final contra un fallo que un sistema de monitorización independiente debería detectar.
Tres incidentes, tres modos de fallo, un problema
Técnicamente, los tres casos fueron muy diferentes.
- En el Karolinska, se interrumpió el suministro que alimentaba el entorno controlado y la organización no consiguió restablecerlo a tiempo.
- En Cleveland, el propio sistema de alarma remota no estaba disponible.
- En el Pacific Fertility, la observación humana detectó un deterioro de las condiciones que la protección automatizada aparentemente no logró señalar de forma fiable.
El problema subyacente era notablemente similar. La organización no podía cerrar de forma fiable el círculo entre un cambio en el entorno crítico y una intervención eficaz.
Ese círculo necesita mucho más que un sensor. Necesita:
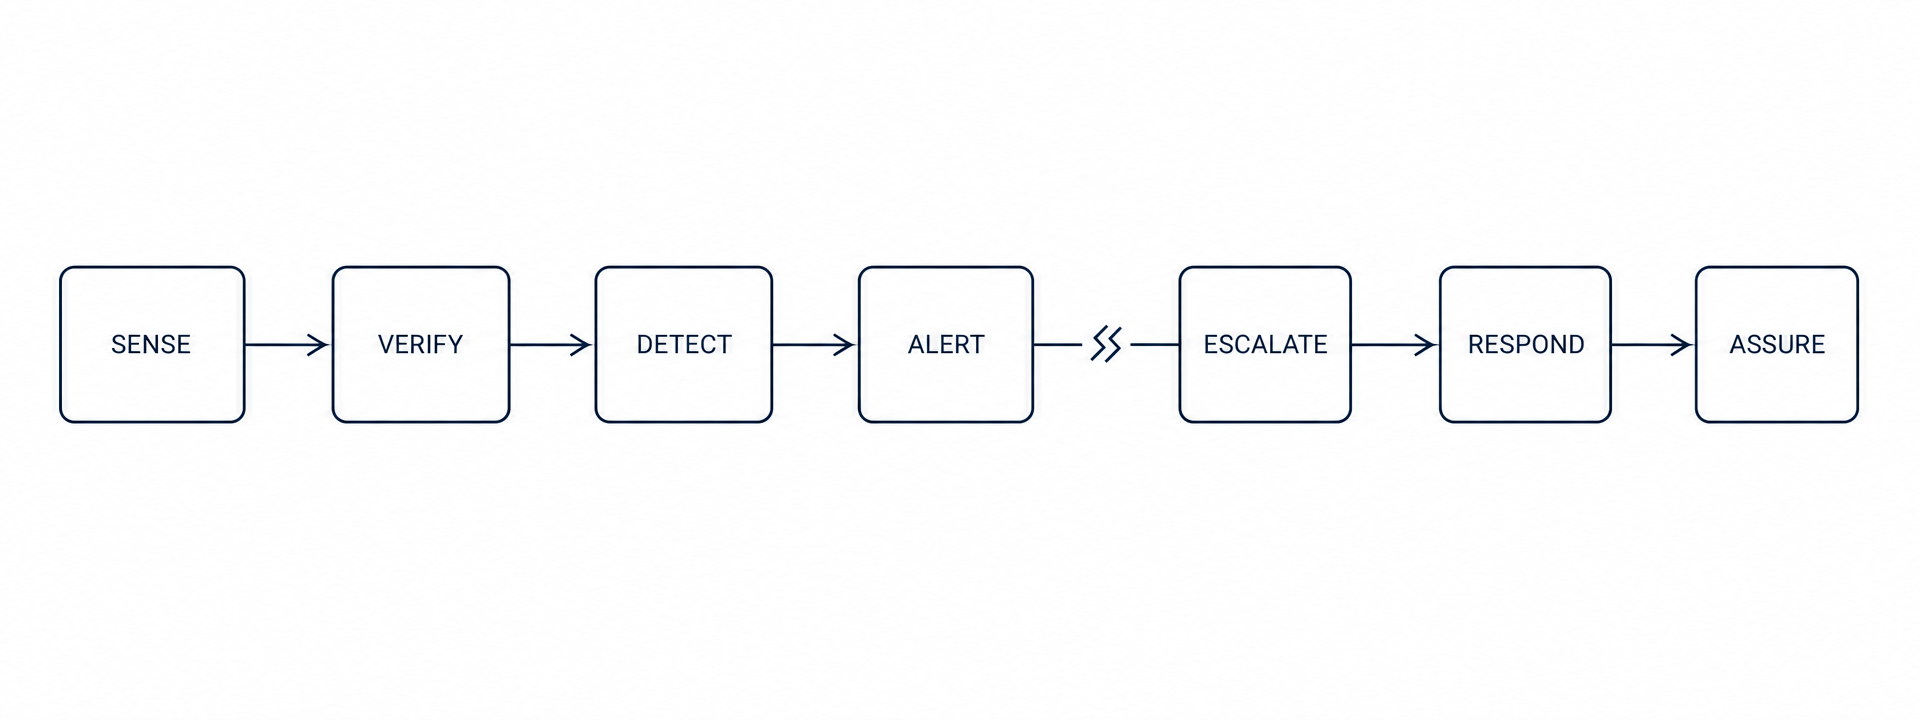
Y cada eslabón importa:
- una válvula puede cerrarse
- un tanque puede perder nitrógeno
- un sensor puede fallar
- una conexión de red puede desaparecer
- una alarma puede desactivarse
- un número de teléfono puede no estar actualizado, un correo electrónico puede acabar en la carpeta de correo no deseado, una intervención de mantenimiento puede cambiar el estado de un sistema
- la persona responsable puede no estar disponible
- una alarma anterior puede crear fatiga por alarmas
Ninguno de estos sucesos es necesariamente catastrófico por sí solo. La catástrofe se produce cuando la organización no puede detectar, comprender y responder a la cadena de sucesos antes de que se agote el margen de seguridad restante.
Los límites de la monitorización ambiental convencional
La monitorización ambiental tradicional se basa en una proposición sencilla: medir el entorno y generar una alarma cuando se supera un umbral.
Ese modelo sigue siendo esencial, pero los entornos críticos exigen más. Pensemos en el Karolinska. La simple monitorización de la temperatura de los tanques criogénicos solo habría detectado el problema después de que el suministro de LN₂ ya se hubiera interrumpido y la reserva hubiera empezado a desaparecer.
Un enfoque más resiliente también se pregunta:
- ¿Funciona el suministro de LN₂?
- ¿Está funcionando el sistema de reposición?
- ¿Ha cambiado una intervención de mantenimiento el estado del sistema?
- ¿Se está produciendo realmente la recarga prevista?
- ¿Está operativo el propio sistema de alarmas?
- ¿Están recibiendo las alertas las personas adecuadas?
- ¿Ha acusado alguien recibo del suceso?
- ¿Qué ocurre si nadie responde?
- ¿Existe una escalada 24/7?
- ¿Puede la organización demostrar lo que ocurrió?
Esta es la diferencia entre medir un entorno y garantizar un entorno.
De la monitorización ambiental a la garantía operativa
La garantía operativa parte de una pregunta diferente. No «¿cuál es la temperatura?», sino «¿podemos demostrar que este entorno crítico permanece bajo control?»
Eso requiere una capa independiente que conecte infraestructura, datos, tecnología y personas. Significa comprender continuamente no solo las condiciones ambientales, sino también el estado del sistema responsable de proteger esas condiciones. En la práctica:
- reconocer patrones anómalos
- detectar la pérdida de comunicación
- verificar que las alarmas estén operativas
- saber quién es el responsable de un suceso crítico
- escalar cuando una alerta no es atendida
- mantener un registro auditable de lo que ocurrió y de cómo respondió la organización
- reconocer que la advertencia más importante puede llegar antes de que el parámetro ambiental final cruce su umbral crítico
El objetivo no es prometer que los equipos nunca fallarán. Los equipos fallarán. El objetivo es asegurarse de que el fallo de un equipo no se convierta silenciosamente en el fallo de un activo.
En qué se diferencia XiltriX Resilience
XiltriX Resilience se diseñó en torno a este principio. En lugar de tratar la monitorización ambiental como un conjunto de sensores, alarmas y paneles de control, crea una capa de garantía operativa independiente en torno a los entornos críticos, conectando tres elementos esenciales.
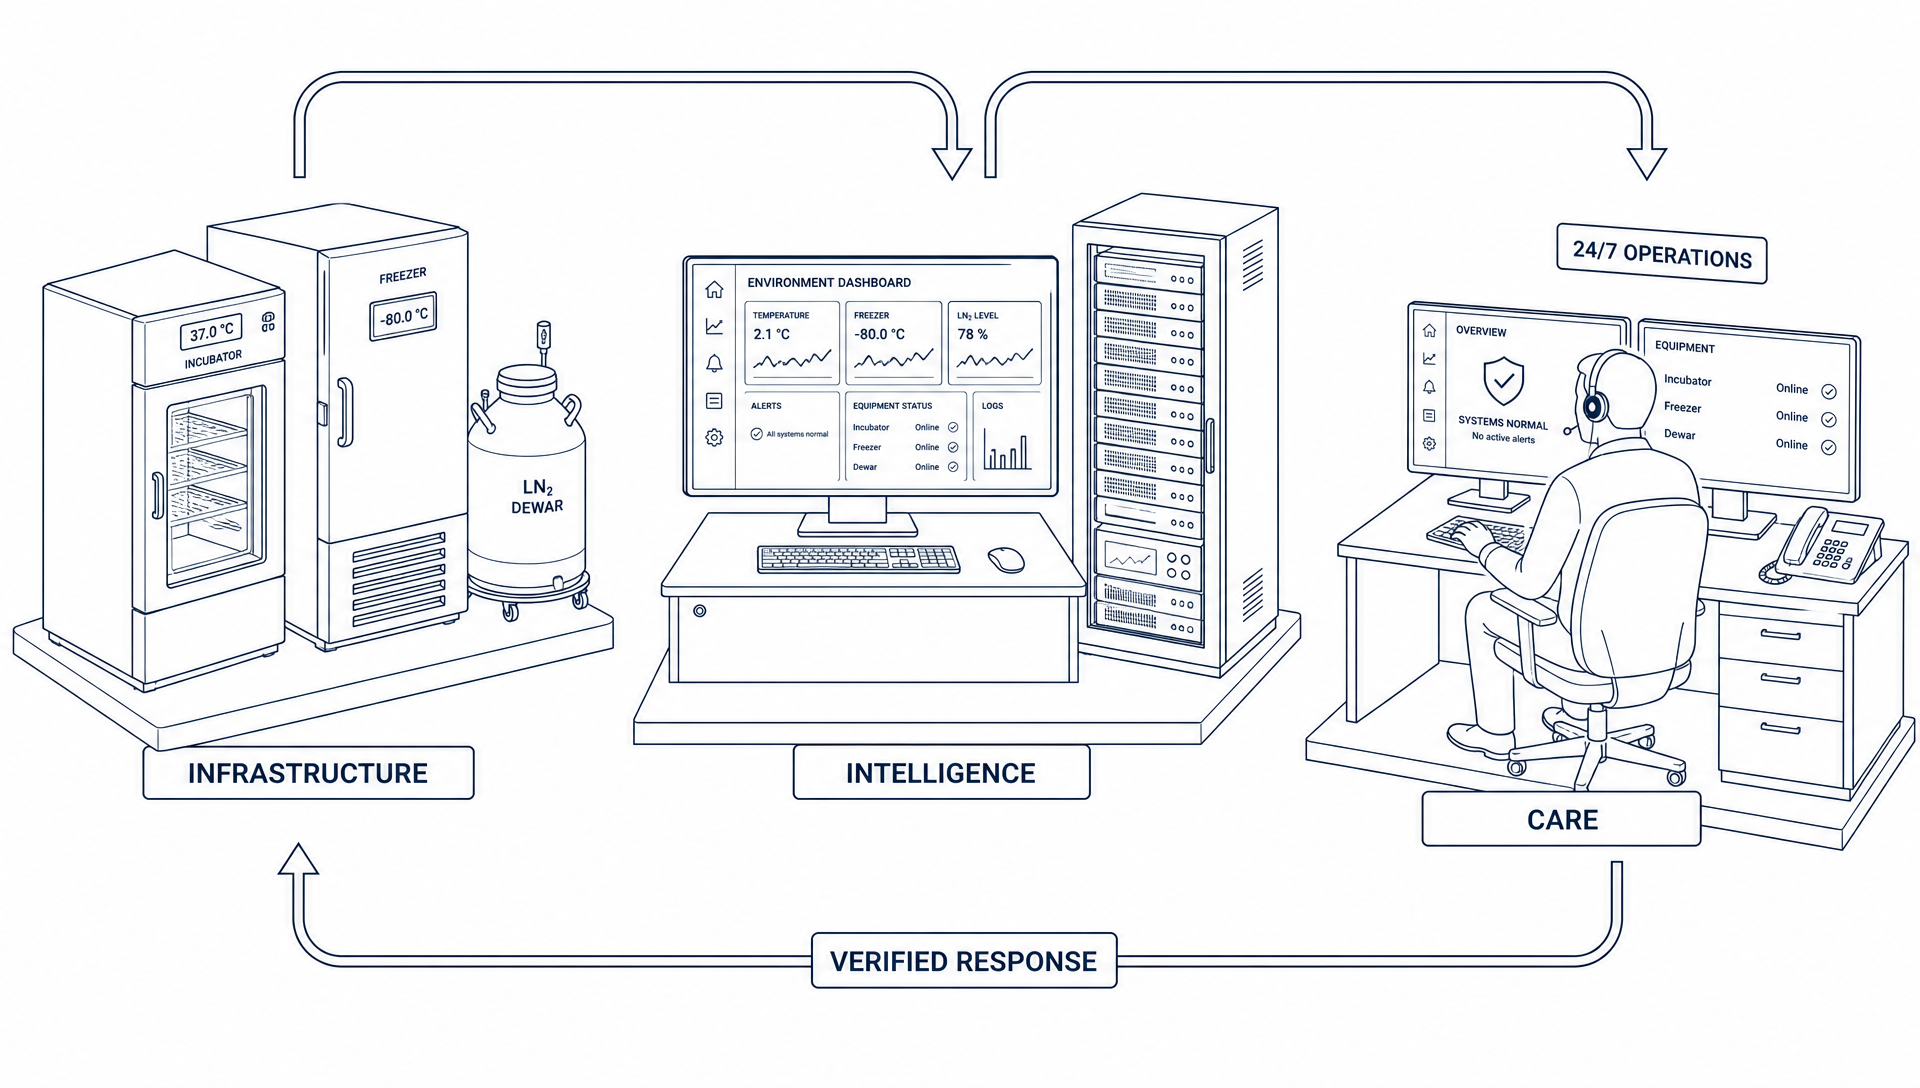
Infrastructure. Los sistemas y activos físicos que crean y mantienen el entorno requerido.
Intelligence. La recopilación, validación e interpretación continuas de datos ambientales y operativos, identificando no solo desviaciones, sino también patrones, anomalías y fallos en la propia cadena de monitorización.
Care. Las personas, los procesos y la responsabilidad que convierten un problema detectado en una respuesta adecuada en lugar de en otra alarma sin respuesta.
Juntos forman un círculo de garantía cerrado:
Infrastructure → Intelligence → Alerta → Escalada → Care → Respuesta verificada
Esto es fundamentalmente diferente de instalar más sensores. La lección del Karolinska, Cleveland y Pacific Fertility no es que los laboratorios necesiten más datos. Necesitan la confianza de que se puede depender de los datos, la infraestructura y el sistema de respuesta cuando más importa.
Sucesos ordinarios, consecuencias irreversibles
Los tres incidentes de este artículo no fueron causados por un único fallo extraordinario. Surgieron de sucesos ordinarios:
- una intervención de mantenimiento
- una válvula cerrada
- una reserva agotada
- una alarma desactivada
- un mecanismo de detección fallido
- una respuesta incompleta
Precisamente por eso son importantes. Los entornos de laboratorio críticos no fallan solo cuando ocurre algo espectacular. Fallan cuando pequeñas desviaciones se acumulan sin ser detectadas, comprendidas o atendidas.
La garantía operativa consiste en hacer visibles esas cadenas invisibles e interrumpirlas antes de que se vuelvan irreversibles.
De eso se trata XiltriX Resilience. No solo de informarle de cuándo ha cambiado el entorno, sino de proporcionarle la confianza continua de que el entorno, el sistema de monitorización y el proceso de respuesta están colaborando para proteger lo que no se puede reemplazar.
Nothing left to chance.
Visítenos en WOTS 2026
XiltriX estará en WOTS, World of Industry, Technology & Science, del 22 al 25 de septiembre de 2026 en Jaarbeurs Utrecht, stand 11B006. Venga a ver qué significa la resiliencia operativa en la práctica y cómo XiltriX Resilience ofrece garantía de activos y procesos.