À l'Institut Karolinska, au Cleveland Fertility Center et au Pacific Fertility Center, des laboratoires sophistiqués surveillaient des environnements conçus pour protéger des matières biologiques irremplaçables. Des milliers d'échantillons ont tout de même été perdus. Non pas parce que personne ne surveillait, mais parce que la surveillance seule n'était pas suffisante.
Ces incidents révèlent une faiblesse fondamentale dans la manière dont les environnements de laboratoire critiques sont souvent protégés. Les capteurs mesurent. Les alarmes alertent. Les tableaux de bord affichent. Mais lorsque quelque chose ne va pas, rien de tout cela ne garantit que la bonne personne sera informée, comprendra, prendra ses responsabilités et agira à temps.
La différence entre la surveillance et l'assurance opérationnelle se mesure à ce qui se passe ensuite.
Institut Karolinska : la défaillance a commencé avant que la température ne change
En décembre 2023, l'Institut Karolinska a subi une défaillance catastrophique de l'infrastructure de stockage cryogénique de son site Neo à Stockholm. Environ 47 100 échantillons biologiques, accumulés sur des décennies, ont finalement été perdus.
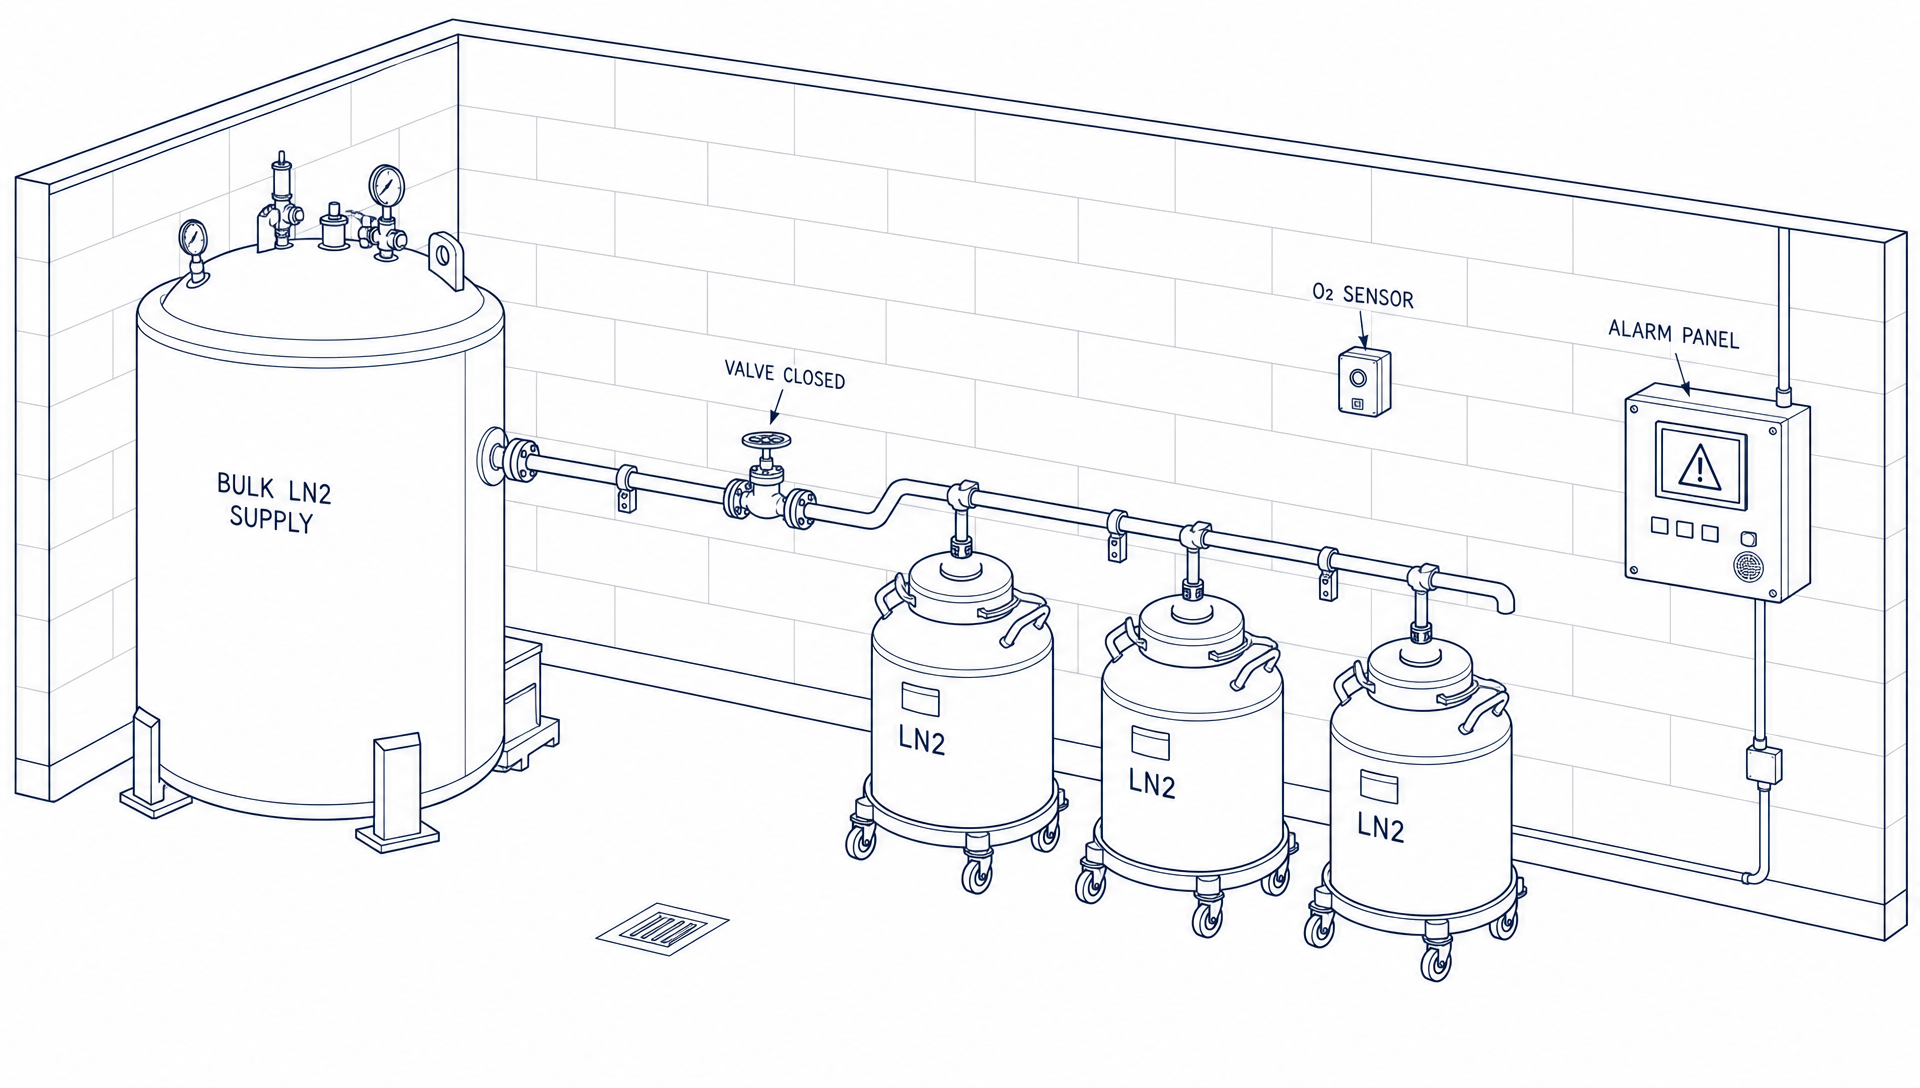
L'enquête est révélatrice, précisément parce que l'incident n'a pas commencé par un congélateur devenant soudainement trop chaud. Lors d'une maintenance planifiée, une alarme de niveau d'oxygène a été déclenchée. Cela a fermé la vanne du réservoir principal d'azote liquide et interrompu l'alimentation des cuves de stockage cryogénique. L'alimentation n'a jamais été rétablie.
Les cuves individuelles contenaient suffisamment de réserve pour fonctionner pendant un certain temps, de sorte que leurs niveaux d'azote liquide ont diminué progressivement. Ce n'est que plus tard que les conditions à l'intérieur des cuves se sont détériorées. La séquence a été la suivante :
Événement de maintenance → alimentation en N₂L interrompue → réserve épuisée → conditions détériorées → alarmes générées → intervention échouée → échantillons perdus.
L'analyse post-mortem a révélé une chaîne de défaillances techniques et organisationnelles plutôt qu'une seule erreur isolée. Les responsabilités n'étaient pas claires. La communication et le partage d'informations étaient inadéquats. Les tests d'alarme étaient insuffisants. Les coordonnées de contact n'étaient pas à jour. Les incidents précédents n'avaient pas été correctement documentés, et l'organisation n'avait pas de capacité de réponse efficace 24h/24 et 7j/7 pendant la période de Noël.
Les alarmes n'étaient pas simplement absentes. Des signaux ont été générés. Des messages ont été envoyés. Ce qui manquait à l'organisation, c'était un mécanisme fiable pour transformer ces signaux en une réponse vérifiée.
La leçon est profonde : un système d'alarme n'est pas un système de contrôle. C'est un maillon dans un système de contrôle.
Cleveland Fertility Center : quand le filet de sécurité a été désactivé
En mars 2018, le University Hospitals Fertility Center de Cleveland a subi un incident de stockage cryogénique affectant plus de 4 000 ovocytes et embryons appartenant à environ 950 patients.
La cuve de stockage disposait d'une alarme à distance destinée à avertir le personnel lorsque les conditions se détérioraient. L'alarme avait été désactivée. L'hôpital n'a pas pu établir quand elle avait été désactivée, ni par qui. La cuve avait également des problèmes avec son système de remplissage d'azote liquide. Lorsque les conditions de stockage se sont détériorées, l'avertissement à distance attendu n'a tout simplement pas fourni la protection pour laquelle il était conçu.
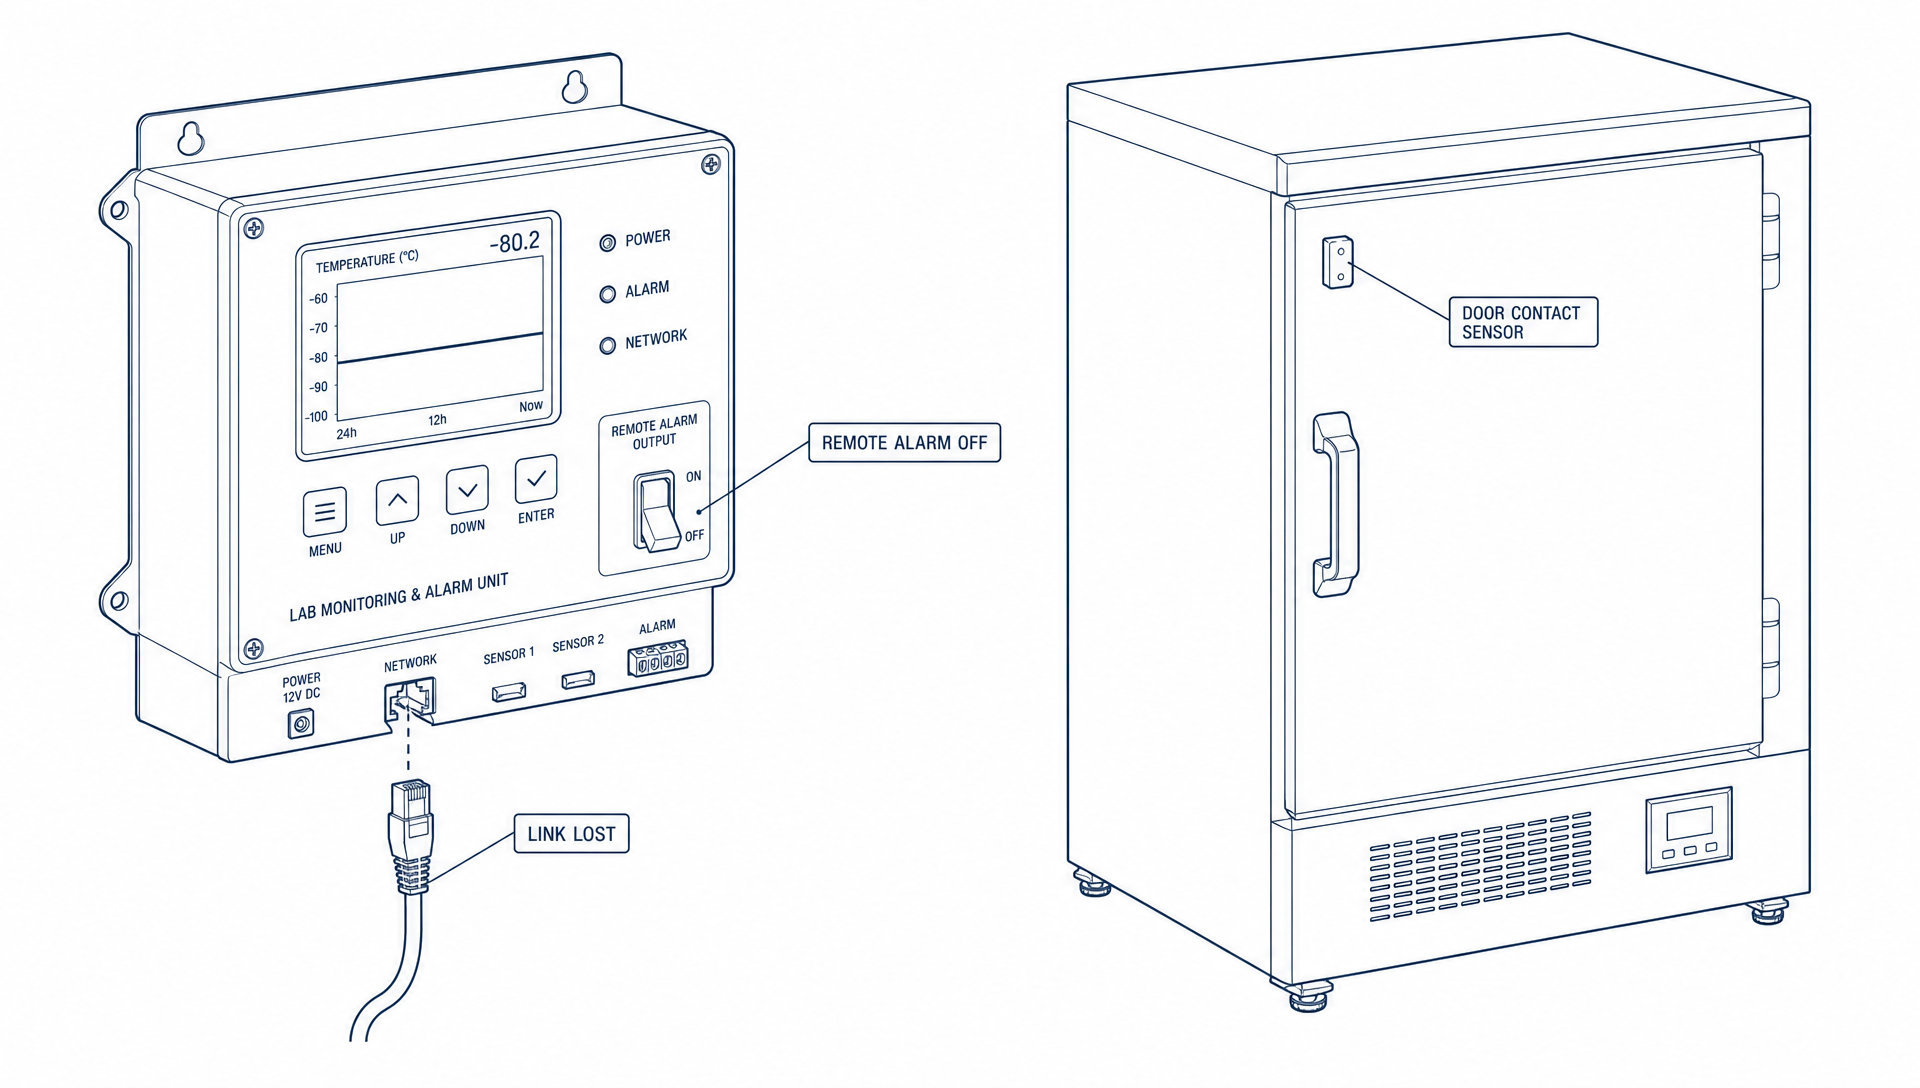
C'est une faiblesse différente de celle de Karolinska. La question n'était pas de savoir si une alarme existait, mais si l'organisation savait que l'alarme elle-même était disponible, connectée et opérationnelle.
Un système de surveillance qui peut devenir silencieusement indisponible crée quelque chose de plus dangereux qu'une absence totale de surveillance : un faux sentiment de confiance.
Pacific Fertility Center : l'humain est devenu la dernière ligne de défense
Le même jour que l'incident de Cleveland, le Pacific Fertility Center de San Francisco a subi une défaillance de stockage cryogénique dans une cuve contenant environ 2 500 embryons et 1 500 ovocytes.
Ce cas enseigne la leçon inverse. Un embryologiste a découvert lors d'une inspection physique que le niveau d'azote liquide dans une cuve avait chuté dangereusement. L'équipe a réagi immédiatement et a transféré le matériel dans une autre cuve. L'inspection humaine est devenue la barrière de sécurité critique.
Les enquêtes ultérieures ont examiné la défaillance de la cuve ainsi que la fiabilité et la redondance de ses systèmes de surveillance et d'alarme. Des rapports détaillés ont mis en évidence un problème auquel chaque clinique de fertilité et chaque installation cryogénique est confrontée : aucune protection unique ne doit être considérée comme infaillible.
La leçon n'est pas que l'inspection humaine est inutile. C'est que l'inspection humaine ne devrait pas avoir à être la dernière défense contre une défaillance qu'un système de surveillance indépendant devrait détecter.
Trois incidents, trois modes de défaillance, un seul problème
Techniquement, les trois cas étaient très différents.
- À Karolinska, l'alimentation de l'environnement contrôlé a été interrompue et l'organisation n'a pas réussi à la rétablir à temps.
- À Cleveland, le système d'alarme à distance lui-même était indisponible.
- Au Pacific Fertility, l'observation humaine a permis de constater une condition qui se détériorait et que la protection automatisée n'avait apparemment pas réussi à signaler de manière fiable.
Le problème sous-jacent était remarquablement similaire. L'organisation ne pouvait pas boucler de manière fiable la boucle entre un changement dans l'environnement critique et une intervention efficace.
Cette boucle nécessite bien plus qu'un simple capteur. Elle nécessite :
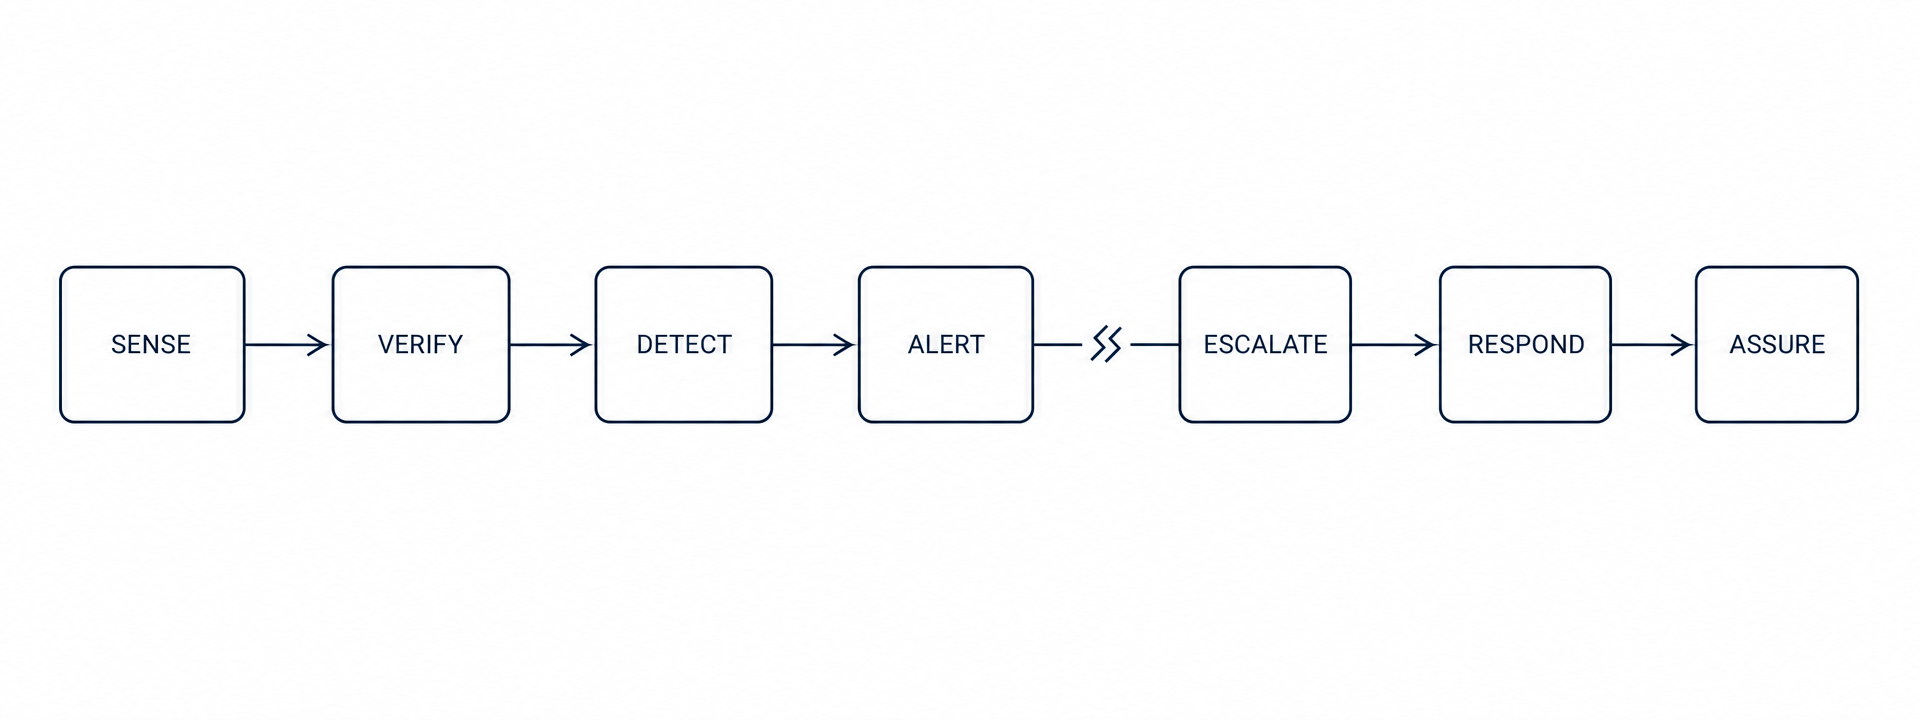
Et chaque maillon compte :
- une vanne peut être fermée
- une cuve peut perdre de l'azote
- un capteur peut tomber en panne
- une connexion réseau peut disparaître
- une alarme peut être désactivée
- un numéro de téléphone peut ne plus être à jour, un e-mail peut atterrir dans un dossier de courrier indésirable, une intervention de maintenance peut changer l'état d'un système
- la personne responsable peut être indisponible
- une alarme précédente peut créer une fatigue d'alarme
Aucun de ces événements n'est nécessairement catastrophique en soi. La catastrophe se produit lorsque l'organisation ne peut pas détecter, comprendre et répondre à la chaîne d'événements avant que la marge de sécurité restante ne soit épuisée.
Les limites de la surveillance environnementale conventionnelle
La surveillance environnementale traditionnelle repose sur une proposition simple : mesurer l'environnement et déclencher une alarme lorsqu'un seuil est dépassé.
Ce modèle reste essentiel, mais les environnements critiques exigent plus. Prenons le cas de Karolinska. La seule surveillance de la température des cuves cryogéniques n'aurait détecté le problème qu'après l'interruption de l'alimentation en N₂L et le début de l'épuisement de la réserve.
Une approche plus résiliente pose également les questions suivantes :
- L'alimentation en N₂L fonctionne-t-elle ?
- Le système de réapprovisionnement est-il opérationnel ?
- Une intervention de maintenance a-t-elle changé l'état du système ?
- Le remplissage attendu a-t-il réellement lieu ?
- Le système d'alarme lui-même est-il opérationnel ?
- Les bonnes personnes reçoivent-elles les alertes ?
- Quelqu'un a-t-il accusé réception de l'événement ?
- Que se passe-t-il si personne ne répond ?
- Y a-t-il une escalade 24h/24 et 7j/7 ?
- L'organisation peut-elle prouver ce qui s'est passé ?
C'est la différence entre mesurer un environnement et assurer un environnement.
De la surveillance environnementale à l'assurance opérationnelle
L'assurance opérationnelle part d'une question différente. Non pas « quelle est la température ? », mais « pouvons-nous démontrer que cet environnement critique reste sous contrôle ? »
Cela nécessite une couche indépendante reliant l'infrastructure, les données, la technologie et les personnes. Cela signifie comprendre en continu non seulement la condition environnementale, mais aussi la santé du système responsable de la protection de cette condition. En pratique :
- reconnaître des schémas anormaux
- détecter la perte de communication
- vérifier que les alarmes sont opérationnelles
- savoir qui est responsable d'un événement critique
- escalader lorsqu'une alerte n'est pas prise en compte
- conserver un enregistrement vérifiable de ce qui s'est passé et de la manière dont l'organisation a réagi
- reconnaître que l'avertissement le plus important peut arriver avant que le paramètre environnemental final ne franchisse son seuil critique
L'objectif n'est pas de promettre que l'équipement ne tombera jamais en panne. L'équipement tombera en panne. L'objectif est de s'assurer que la défaillance de l'équipement ne se transforme pas silencieusement en une défaillance des actifs.
En quoi XiltriX Resilience est différent
XiltriX Resilience a été conçu autour de ce principe. Plutôt que de traiter la surveillance environnementale comme un ensemble de capteurs, d'alarmes et de tableaux de bord, il crée une couche d'assurance opérationnelle indépendante autour des environnements critiques, reliant trois éléments essentiels.
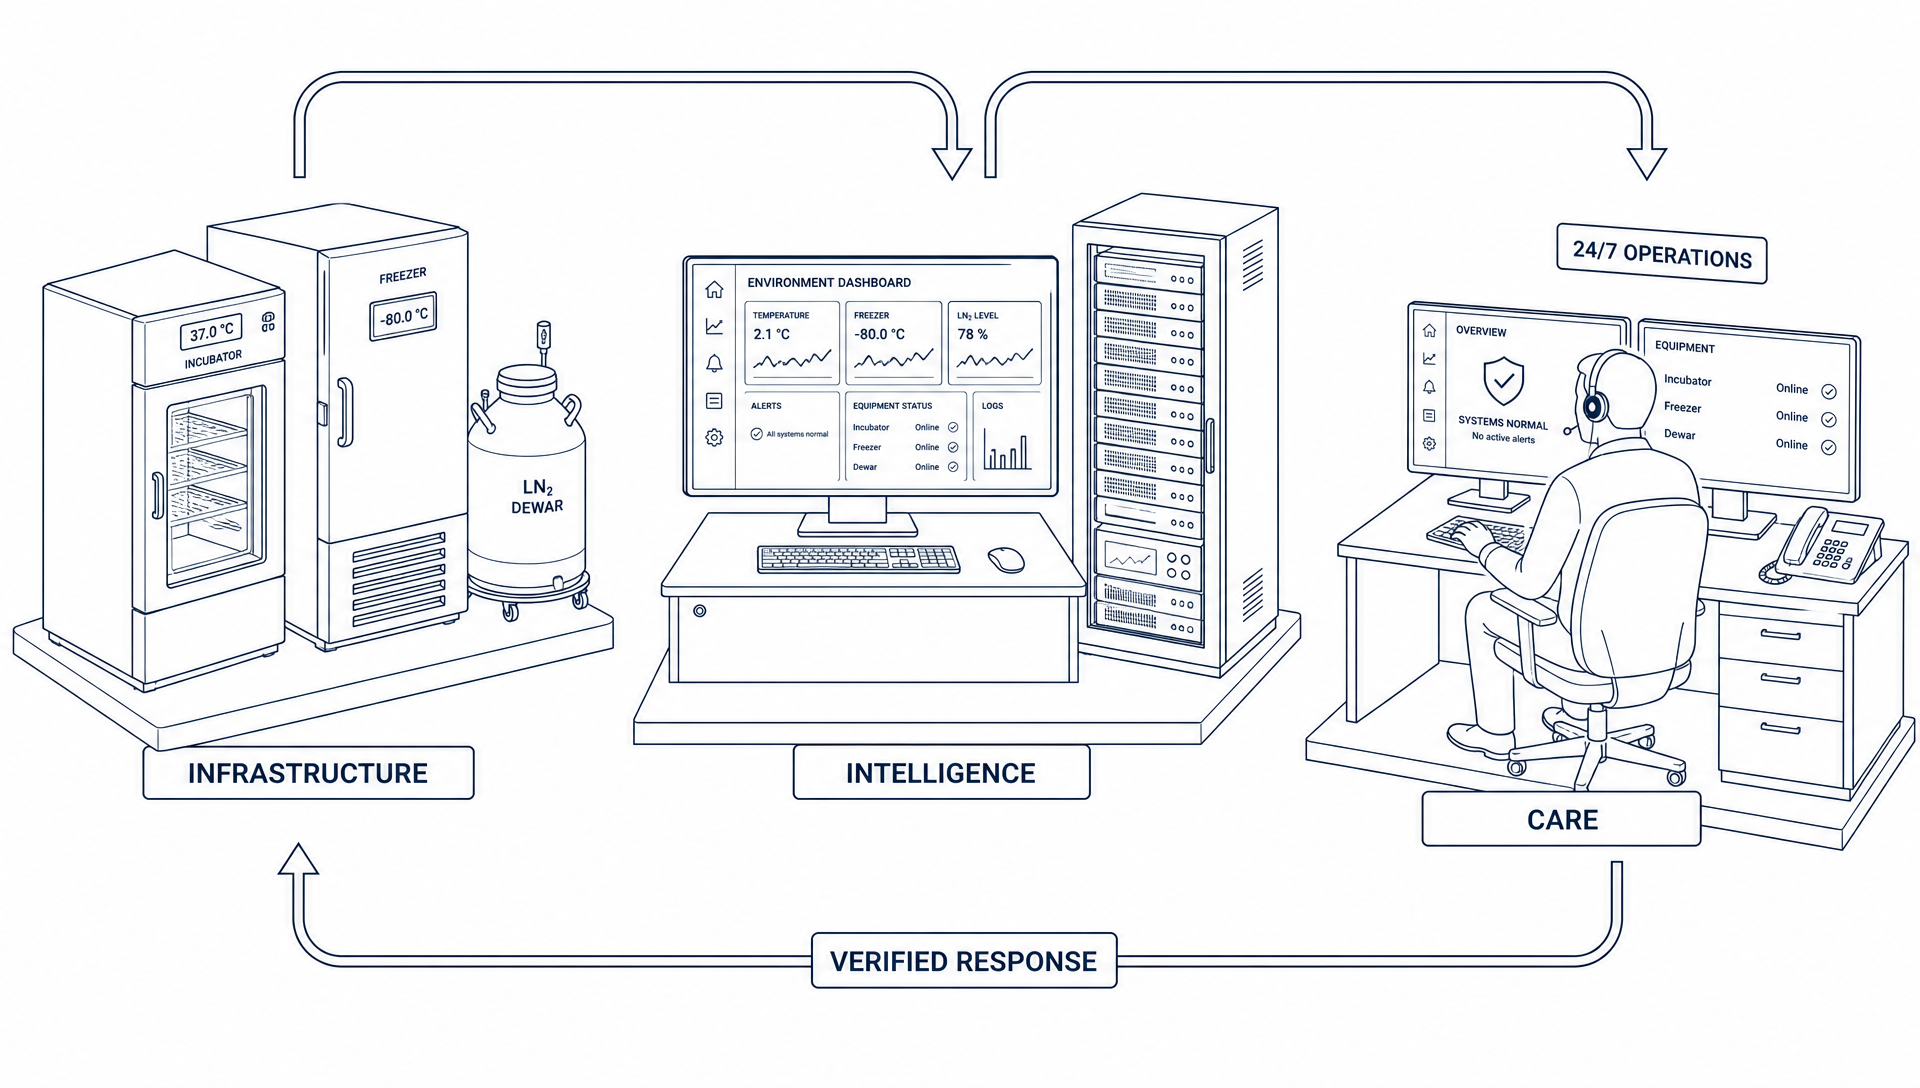
Infrastructure. Les systèmes et actifs physiques qui créent et maintiennent l'environnement requis.
Intelligence. La collecte, la validation et l'interprétation continues des données environnementales et opérationnelles, identifiant non seulement les écarts mais aussi les schémas, les anomalies et les défaillances dans la chaîne de surveillance elle-même.
Care. Les personnes, les processus et la responsabilité qui transforment un problème détecté en une réponse appropriée plutôt qu'en une autre alarme sans réponse.
Ensemble, ils forment une boucle d'assurance fermée :
Infrastructure → Intelligence → Alerte → Escalade → Care → Réponse vérifiée
C'est fondamentalement différent de l'installation de plus de capteurs. La leçon de Karolinska, Cleveland et Pacific Fertility n'est pas que les laboratoires ont besoin de plus de données. Ils ont besoin de la confiance que les données, l'infrastructure et le système de réponse peuvent être fiables lorsque cela compte le plus.
Événements ordinaires, conséquences irréversibles
Les trois incidents décrits dans cet article n'ont pas été causés par une seule défaillance extraordinaire. Ils sont nés d'événements ordinaires :
- une intervention de maintenance
- une vanne fermée
- une réserve épuisée
- une alarme désactivée
- un mécanisme de détection défaillant
- une réponse incomplète
C'est précisément pour cette raison qu'ils sont importants. Les environnements de laboratoire critiques ne tombent pas en panne uniquement lorsque quelque chose de spectaculaire se produit. Ils tombent en panne lorsque de petits écarts s'accumulent sans être détectés, compris ou traités.
L'assurance opérationnelle consiste à rendre visibles ces chaînes invisibles et à les interrompre avant qu'elles ne deviennent irréversibles.
C'est l'objet de XiltriX Resilience. Il ne s'agit pas simplement de vous dire quand l'environnement a changé, mais de fournir une confiance continue que l'environnement, le système de surveillance et le processus de réponse fonctionnent tous ensemble pour protéger ce qui ne peut être remplacé.
Nothing left to chance.
Retrouvez-nous au WOTS 2026
XiltriX sera présent au WOTS, World of Industry, Technology & Science, du 22 au 25 septembre 2026 à Jaarbeurs Utrecht, stand 11B006. Venez voir ce que signifie la résilience opérationnelle en pratique et comment XiltriX Resilience assure la protection des actifs et des processus.